
Table des matières de l'article :
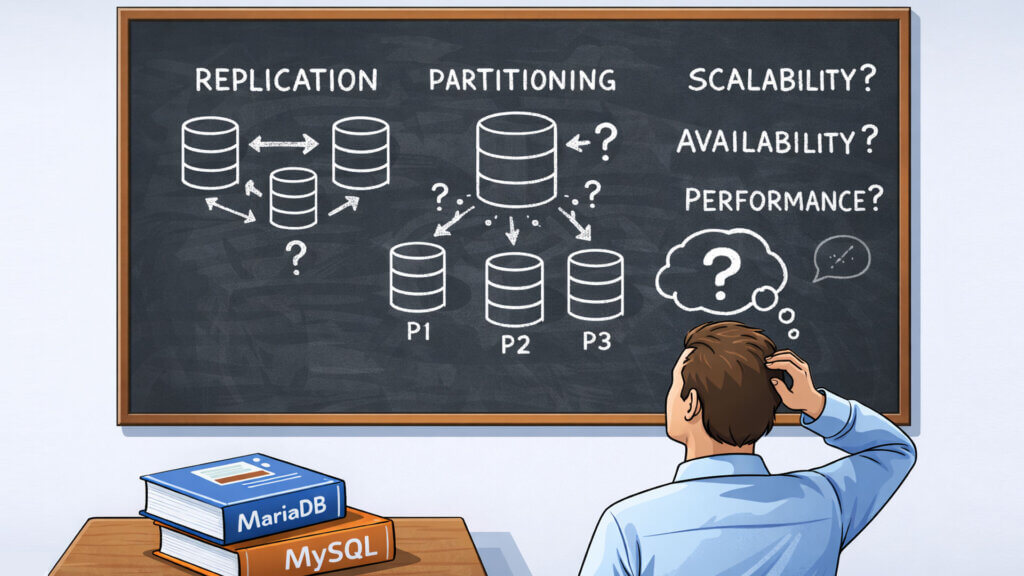
Dans le monde de la conception de systèmes distribués, de la mise à l'échelle des bases de données et des architectures modernes axées sur la performance, trois concepts sont souvent mentionnés mais rarement pleinement compris : la réplication, le partitionnement et le sharding.
La confusion provient du fait que ces trois techniques, d'une manière ou d'une autre, abordent la gestion et la distribution des données. Cependant, chacune résout des problèmes totalement différents, opère à des niveaux architecturaux différents et induit des impacts très spécifiques sur les performances, la fiabilité, les coûts opérationnels et la complexité de la gestion.
Bien comprendre ces différences n'est pas qu'un simple exercice théorique. C'est une compétence fondamentale pour ceux qui gèrent des CMS à fort trafic, des plateformes de commerce électronique, des applications SaaS, des infrastructures d'hébergement professionnelles ou des systèmes basés sur des microservices.
Dans cet article, nous analysons de manière claire et pragmatique ce que sont la réplication, le partitionnement et le sharding, les problèmes qu'ils résolvent, quand ils sont judicieux et quand ils constituent une erreur, comment ils sont utilisés dans le monde réel et pourquoi ils sont souvent combinés.
Réplication : Haute disponibilité et évolutivité en lecture

Qu'est-ce que la réplication ?
La réplication est une technique d'architecture de bases de données qui consiste à maintenir des copies identiques d'un même ensemble de données sur plusieurs serveurs distincts , synchronisées automatiquement entre elles. Chaque nœud de réplique stocke l'intégralité de la base de données, ou du moins l'ensemble des données pertinentes pour l'application, constamment mises à jour en fonction des modifications apportées au nœud principal.
Conceptuellement, la réplication ne fragmente ni ne divise les données : elle les duplique . Il est essentiel de comprendre ce point, car il définit clairement les avantages et les limites de cette solution. Chaque serveur impliqué dans la réplication dispose d'une copie complète de la base de données, prête à répondre aux requêtes.
Le modèle le plus courant dans les bases de données relationnelles est le modèle leader-suiveur, également appelé réplication primaire. Dans cette configuration, un nœud leader accepte toutes les opérations d'écriture (insertions, mises à jour et suppressions), tandis qu'un ou plusieurs nœuds de réplication gèrent principalement les requêtes de lecture. Les modifications apportées au nœud leader sont propagées aux réplicas de manière asynchrone ou semi-synchrone, selon la configuration.
Cette approche permet une séparation nette des charges de lecture et d'écriture, améliorant ainsi la réactivité globale du système et réduisant la charge sur le nœud maître. C'est une solution largement adoptée dans les architectures basées sur MySQL, MariaDB et PostgreSQL, notamment dans les contextes d'hébergement traditionnel et d'applications web.
Il existe également des modèles plus avancés, tels que les architectures multi-leaders, où plusieurs nœuds acceptent les écritures, ou les architectures sans leader, typiques de certaines bases de données distribuées modernes. Cependant, ces approches sont moins courantes dans les environnements d'hébergement traditionnels car elles introduisent des complexités supplémentaires liées à la résolution des conflits, à la cohérence des données et à la gestion des transactions.
Dans la plupart des scénarios, notamment dans le monde des CMS et des applications web, le modèle leader-suiveur reste le meilleur compromis entre simplicité, fiabilité et performance.
Quel est le véritable objectif de la réplication ?
L'une des erreurs conceptuelles les plus fréquentes consiste à penser que la réplication sert à « augmenter la taille de la base de données » au sens générique du terme. En réalité, la réplication n'est pas conçue pour augmenter le volume de données ni la capacité d'écriture du système.
Son objectif principal est différent : garantir une haute disponibilité , la continuité de service et la tolérance aux pannes . En cas de problème matériel, logiciel ou réseau sur le nœud principal, la présence d’une ou plusieurs répliques permet de réduire considérablement les temps d’arrêt et, dans de nombreux cas, d’assurer un basculement rapide.
Un deuxième objectif fondamental est la scalabilité des lectures . Dans de nombreuses applications web, le nombre d'opérations de lecture dépasse largement celui des écritures. Prenons l'exemple d'un site de contenu, d'un blog ou d'une plateforme d'information : chaque visite génère des dizaines de requêtes SELECT, mais très peu d'opérations d'écriture.
Dans ces contextes, la réplication permet de répartir la charge de lecture sur plusieurs nœuds, améliorant ainsi les temps de réponse et la capacité globale du système sans avoir à intervenir de manière invasive dans l'application.
La réplication est donc idéale dans tous les contextes où la charge est principalement axée sur la lecture, les écritures sont limitées ou centralisées, et où il est essentiel d'éviter toute interruption de service. C'est une solution qui privilégie la stabilité, la fiabilité et la résilience plutôt qu'une croissance illimitée.
Avantages concrets de la réplication
D'un point de vue opérationnel, la réplication offre un certain nombre d'avantages très concrets qui en font l'un des premiers choix lorsqu'une base de données autonome commence à montrer ses limites.
L'un des avantages les plus évidents est la capacité à effectuer un basculement rapide . En cas de défaillance du nœud principal, un nœud répliqué peut être promu au rang de nouveau maître, réduisant ainsi considérablement les temps d'arrêt. Dans les environnements bien conçus, ce processus peut être automatisé ou géré rapidement et efficacement.
Un autre avantage important réside dans la réduction de la charge sur le nœud maître . En déplaçant les requêtes de lecture vers les répliques, le nœud maître peut se concentrer sur les opérations d'écriture, ce qui améliore la stabilité globale du système et réduit la latence des opérations critiques.
La réplication permet également d' effectuer des sauvegardes, des analyses et des rapports sur les nœuds répliqués, sans impacter les performances de la base de données de production. Ceci est particulièrement utile dans les environnements hébergés et gérés, où la qualité de service dépend aussi de la capacité à effectuer des tâches de maintenance sans provoquer de ralentissements perceptibles pour les utilisateurs.
Enfin, la réplication représente souvent la première étape naturelle de l'évolution d'une base de données autonome. Elle ne nécessite aucune modification de l'application, est prise en charge nativement par les principales bases de données relationnelles et est relativement simple à gérer du point de vue du système.
Les limites structurelles de la réplication
La limitation la plus importante de la réplication est simple, mais souvent négligée ou mal comprise : chaque réplique contient l’ensemble des données.
Cela signifie que le volume total de données n'est pas réparti sur plusieurs serveurs, mais dupliqué. Par conséquent, si la base de données augmente considérablement, chaque nœud doit disposer de ressources suffisantes pour héberger l'ensemble des données, tant en termes de stockage que de mémoire et de puissance de calcul.
La seconde limitation, encore plus critique, concerne les écritures . Dans un modèle leader-suiveur, toutes les opérations d'écriture transitent par le nœud leader. Ce nœud devient inévitablement un goulot d'étranglement lorsque le nombre d'insertions, de mises à jour et de suppressions augmente significativement.
L'ajout de la réplication ne résout pas ce problème. En fait, dans certains cas, cela peut même l'amplifier, car le nœud principal doit également propager les modifications aux nœuds enfants.
Le nœud principal demeure donc le point critique de l'ensemble du système. Lorsque la charge d'écriture dépasse un certain seuil, la réplication seule ne suffit plus et il devient nécessaire d'envisager différentes approches architecturales, telles que le partitionnement ou le sharding.
Un exemple pratique
Un site WordPress à fort trafic, avec des milliers de visiteurs simultanés et une prédominance de contenu statique ou semi-statique, tire pleinement parti de la réplication MySQL pour les requêtes de lecture. Dans ce cas, la plupart des opérations consistent en des requêtes SELECT sur les articles, les pages et les métadonnées, tandis que les écritures se limitent à la publication de contenu et à quelques opérations d'administration.
La répartition des lectures sur un ou plusieurs nœuds répliqués améliore considérablement les temps de réponse et la stabilité du système, sans introduire de complexité applicative significative.
Un site de commerce électronique, en revanche, présente un schéma complètement différent. Chaque visite peut générer des écritures liées aux paniers, aux sessions, aux commandes, aux paiements et aux mises à jour des stocks. Dans ces cas-là, le nœud principal est rapidement saturé d'opérations d'écriture et la réplication révèle toutes ses limites structurelles.
Dans ce contexte, la réplication reste utile pour la haute disponibilité et certaines opérations de lecture, mais elle ne suffit pas à elle seule pour accompagner la croissance du système. C'est précisément là qu'il est nécessaire d'envisager des solutions architecturales plus avancées.
Partitionnement : Organisez mieux vos données, ne répartissez pas la charge.

Qu'est-ce que le partitionnement ?
Le partitionnement est une technique d'organisation interne des données qui consiste à diviser une grande table en plusieurs partitions logiques , toutes gérées au sein du même serveur de base de données . Contrairement à d'autres solutions de répartition de charge, le partitionnement ne déplace pas les données entre machines, mais les organise plus efficacement sur le même système.
Chaque partition ne contient qu'une partie des lignes de la table , définie selon une règle spécifique. Les stratégies les plus courantes consistent à partitionner par intervalle de temps, par liste de valeurs spécifiques ou à utiliser une fonction de hachage appliquée à une ou plusieurs colonnes. Le choix du critère de partitionnement est crucial, car il influe directement sur l'efficacité de la solution.
Du point de vue de l'application, et donc du code interrogeant la base de données, il n'y a qu'une seule table . Il n'est pas nécessaire de modifier les requêtes ni d'introduire de logique applicative supplémentaire. Le moteur de base de données détermine automatiquement la partition à interroger en fonction des conditions de la requête.
Cet aspect rend le partitionnement particulièrement intéressant dans les contextes où il n'est pas possible ou souhaitable d'intervenir sur l'application, mais où l'on souhaite tout de même améliorer l'efficacité de la base de données.
À quoi sert réellement le partitionnement ?
Le partitionnement n'est pas conçu pour faire évoluer l'infrastructure ni pour répartir la charge sur plusieurs serveurs. Son objectif principal est d'améliorer les performances des très grandes tables et de rendre leur croissance plus gérable au fil du temps.
Lorsqu'une table devient volumineuse, même des opérations apparemment simples peuvent s'avérer coûteuses. Les analyses complètes prennent plus de temps, les index deviennent plus lourds et les opérations de maintenance peuvent impacter significativement les performances globales de la base de données.
Le partitionnement répond précisément à ces problématiques. Il réduit le coût des analyses, permet à la base de données de traiter des portions de données plus petites, améliore l'efficacité des index et simplifie des opérations telles que le nettoyage des données obsolètes ou l'archivage des informations historiques.
Il s'agit donc d'une technique d'optimisation interne , extrêmement efficace lorsqu'elle est appliquée correctement et dans le bon contexte. Elle ne résout pas les problèmes de charge structurelle, mais elle permet une meilleure utilisation des ressources disponibles.
Les principaux avantages du partitionnement
L'un des avantages les plus évidents du partitionnement est la réduction du temps d'exécution des requêtes sur de très grands ensembles de données. Lorsqu'une requête inclut une condition conforme au critère de partitionnement, la base de données peut se limiter à interroger les seules partitions pertinentes, évitant ainsi d'analyser la totalité de la table.
Ce mécanisme, connu sous le nom d'élagage de partitions, permet des améliorations significatives, notamment sur les tables qui grossissent au fil du temps, telles que celles basées sur des dates ou des identifiants progressifs.
Un autre avantage important est la réduction des conflits internes . Les opérations qui impliquaient auparavant la table entière peuvent être réparties sur plusieurs partitions, ce qui réduit les verrouillages et améliore la concurrence des requêtes.
Le partitionnement simplifie également la gestion des données historiques . Dans de nombreux cas, la suppression des anciennes données ne nécessite plus de suppressions massives, mais simplement la suppression d'une partition entière — une opération beaucoup plus rapide et moins impactante.
Cette technique est particulièrement adaptée aux tables dont le volume augmente continuellement, comme les commandes, les journaux d'applications, les événements, les transactions et les systèmes de suivi. Dans ces cas, le partitionnement permet de maintenir des performances stables malgré l'augmentation des volumes de données.
La limitation fondamentale du partitionnement
La principale limitation du partitionnement est intrinsèque à sa nature : il n’ajoute pas de nouvelles ressources matérielles.
Toutes les partitions résident sur le même serveur et partagent les mêmes ressources. Le processeur, la mémoire, le stockage et le sous-système d'E/S restent inchangés. Le partitionnement améliore l'organisation des données, mais n'augmente pas les performances du système.
Si la base de données est déjà proche de sa limite de ressources, le partitionnement d'une ou plusieurs tables ne la rendra pas soudainement évolutive. Dans certains cas, cela peut améliorer la situation, mais ne résoudra pas les problèmes de saturation structurelle.
Il est donc important de ne pas confondre le partitionnement avec une solution de mise à l'échelle horizontale. C'est un outil d'optimisation, et non une méthode pour étendre l'infrastructure.
Un exemple concret
Une table de commandes contenant des centaines de millions de lignes est un cas classique où le partitionnement peut s'avérer très avantageux. En partitionnant la table par mois ou par année, la base de données peut limiter les requêtes aux seules partitions pertinentes lors de l'interrogation de données récentes, telles que les commandes des trente derniers jours.
Cela se traduit par des requêtes plus rapides, une charge système réduite et une gestion des données historiques grandement simplifiée. La suppression des commandes anciennes peut se faire en effaçant des partitions entières au lieu de procéder à des suppressions sur des millions de lignes.
Il est toutefois essentiel de se rappeler qu'il n'existe qu'une seule base de données. La charge globale n'est pas répartie sur plusieurs machines et les ressources disponibles restent inchangées. Le partitionnement améliore l'efficacité, mais ne remplace pas les solutions de mise à l'échelle telles que le sharding.
Partitionnement : véritable évolutivité horizontale des données

Qu'est-ce que le sharding ?
Le partitionnement (sharding) est une technique architecturale qui permet de répartir des données sur plusieurs machines physiques ou virtuelles en divisant l'ensemble des données en portions indépendantes appelées partitions. Chaque partition représente une fraction autonome de la base de données globale et est hébergée sur un serveur distinct disposant de ressources dédiées.
Contrairement à d'autres solutions qui dupliquent ou organisent les données, le partitionnement divise l'ensemble de données horizontalement , en attribuant à chaque nœud une portion seulement des informations. Ainsi, aucun serveur ne possède l'intégralité de la base de données, mais seulement la portion dont il est responsable.
Chaque partition gère sa propre charge de travail, en lecture comme en écriture. Les requêtes sont acheminées directement vers la partition appropriée en fonction d'une clé de partitionnement, telle qu'un identifiant utilisateur, un identifiant de locataire ou une plage de valeurs. Ceci permet une distribution efficace du trafic et évite les goulots d'étranglement centralisés.
Le sharding est la seule des trois solutions analysées qui permette une véritable évolutivité horizontale , car il permet d'augmenter la capacité du système simplement en ajoutant de nouveaux nœuds et en répartissant une partie des données et de la charge entre eux.
Pourquoi le sharding est conceptuellement différent
Le sharding est conceptuellement différent de la réplication et du partitionnement car il intervient à un niveau plus profond de l'architecture.
Contrairement à la réplication, les données ne sont pas dupliquées , mais réparties. Chaque information réside sur un fragment spécifique et n'est présente sur aucun autre nœud, sauf en cas de mécanismes de réplication internes au sein du fragment pour des raisons de haute disponibilité.
Contrairement au partitionnement, la séparation des données est physique , et non seulement logique. Les partitions ne coexistent pas sur le même serveur, mais sont réparties sur différentes machines, chacune disposant de ses propres ressources de processeur, de mémoire, de stockage et d'E/S.
Cette approche permet une distribution linéaire non seulement du volume de données, mais aussi de la charge de calcul et du trafic d'écriture. À mesure que le nombre d'utilisateurs ou de transactions augmente, de nouvelles partitions peuvent être ajoutées et les performances maintenues dans le temps.
D'un point de vue architectural, le partitionnement représente un véritable changement de paradigme par rapport aux modèles traditionnels basés sur une base de données centrale unique.
Avantages du partitionnement
Le principal avantage du partitionnement réside dans son évolutivité quasi illimitée . En théorie, il n'existe aucune limite supérieure au volume de données ni au nombre d'opérations que le système peut traiter, pourvu que de nouveaux partitionnements puissent être ajoutés et la charge répartie de manière appropriée.
Un autre avantage clé réside dans la réduction drastique des conflits . Chaque partition ne traitant qu'une partie des données, le nombre d'opérations simultanées sur chaque nœud diminue, améliorant ainsi les performances globales et la prévisibilité du système.
Le partitionnement permet également une meilleure gestion des charges importantes , typiques des plateformes à fort trafic, des grands sites de commerce électronique et des services SaaS comptant de nombreux clients actifs. Chaque partition peut être dimensionnée pour répondre à des besoins spécifiques, ce qui rend l'infrastructure plus flexible.
Un autre avantage réside dans la possibilité d' étendre le système progressivement sans migrations brutales . Dans une architecture partitionnée, de nouveaux nœuds peuvent être ajoutés progressivement, sans avoir à déplacer l'intégralité de la base de données ni à subir d'interruption de service prolongée.
Pour les grands systèmes, le partitionnement n'est pas un choix optionnel mais une véritable nécessité architecturale.
Le coût architectural du partitionnement
Malgré ses avantages, le partitionnement introduit une complexité importante qu'il convient de prendre en compte. C'est une solution performante, mais coûteuse à concevoir et à exploiter.
L'un des aspects les plus critiques est la nécessité d' une logique de routage prenant en compte le partitionnement . L'application doit savoir sur quel partitionnement se trouvent les données demandées et acheminer les requêtes correctement. Cela implique des modifications du code et une conception soignée de la clé de partitionnement.
Le partitionnement complexifie également les jointures entre les partitions . Les opérations simples dans une base de données monolithique deviennent difficiles, voire impossibles, lorsque les données résident sur différents nœuds. Les requêtes de parcours, impliquant plusieurs partitions, sont également plus lentes et plus coûteuses.
Les procédures de sauvegarde et de restauration se complexifient , car elles doivent prendre en compte plusieurs bases de données indépendantes. La gestion opérationnelle requiert des outils, des compétences et des processus plus avancés qu'une architecture traditionnelle.
Pour ces raisons, le partitionnement exige une conception applicative réfléchie dès les premières étapes du projet. L'introduire ultérieurement peut s'avérer extrêmement complexe et risqué.
Un exemple concret
Un exemple typique de partitionnement est une plateforme SaaS mutualisée. Dans ce scénario, chaque client ou groupe de clients se voit attribuer un partitionnement spécifique, isolant ainsi ses données et répartissant la charge de manière uniforme.
Les données restent cohérentes, les performances demeurent prévisibles et la croissance de la plateforme devient linéaire. À mesure que le nombre de clients augmente, il suffit d'ajouter de nouveaux fragments et d'y affecter de nouveaux locataires.
Ce modèle est largement utilisé dans les grands services cloud, les plateformes d'entreprise et les systèmes qui doivent gérer des millions d'utilisateurs ou de très grands volumes de données, pour lesquels les solutions traditionnelles ne suffisent plus.
Comparaison côte à côte de la réplication, du partitionnement et du sharding
D’un point de vue pratique, les différences entre la réplication, le partitionnement et le sharding ne peuvent être clairement résumées que si l’on comprend qu’ils ne résolvent pas le même problème.
La réplication est une solution axée sur la disponibilité du service et l'évolutivité en lecture . Elle est conçue pour rendre la base de données plus résiliente aux pannes et pour répartir les requêtes de lecture sur plusieurs nœuds, sans modifier le modèle de données ni l'architecture de l'application.
Le partitionnement , quant à lui, est une technique d'optimisation interne qui améliore l'efficacité de la gestion des très grandes tables. Il n'augmente pas la capacité du système, mais permet une meilleure utilisation des ressources existantes, ce qui accélère les requêtes et simplifie la maintenance.
Enfin, le partitionnement représente un changement de paradigme. C'est la seule des trois solutions qui permet une véritable scalabilité horizontale , autorisant la distribution des données et de la charge sur plusieurs machines et permettant au système de croître au fil du temps sans rencontrer de limitations structurelles.
La confusion entre ces concepts conduit souvent à de mauvaises décisions architecturales. Appliquer la bonne solution au mauvais problème non seulement ne permet pas de résoudre les problèmes critiques, mais peut également engendrer une complexité, des coûts et une rigidité difficiles à corriger ultérieurement.
Les erreurs architecturales les plus courantes
L'une des erreurs les plus fréquentes consiste à utiliser la réplication dans le but de résoudre les problèmes d'écriture. L'ajout de réplication peut améliorer les vitesses de lecture et la disponibilité, mais il ne supprime pas le goulot d'étranglement du nœud maître . À mesure que la charge d'écriture augmente, le nœud maître demeure le point critique du système, quel que soit le nombre de répliques présentes.
Une autre erreur fréquente consiste à introduire le partitionnement sans analyser le modèle de requête réel. Un partitionnement mal conçu, avec des critères incohérents avec les conditions de requête les plus courantes, peut en réalité dégrader les performances au lieu de les améliorer. Dans ce cas, la base de données ne tire pas parti de l'élagage des partitions et finit par se comporter comme une table non partitionnée, avec une surcharge supplémentaire.
Enfin, le partitionnement est souvent introduit trop tôt. Par crainte de limitations futures, certains projets l'adoptent alors que la charge réelle ne le justifie pas encore. Cette approche accroît inutilement la complexité des applications, complique la maintenance et engendre des coûts d'exploitation sans avantages tangibles à court ou moyen terme.
Une bonne architecture résulte de l'analyse de données réelles, et non de prédictions abstraites.
Quand et comment combiner les trois techniques
Dans les architectures modernes les plus robustes, la réplication, le partitionnement et le sharding ne sont pas mutuellement exclusifs , mais coexistent plutôt de manière complémentaire.
Une approche courante consiste à partitionner les données pour répartir la charge globale et le volume de données sur plusieurs nœuds, à effectuer une réplication au sein de chaque partition pour garantir une haute disponibilité et une tolérance aux pannes, et à partitionner les tables pour gérer efficacement les plus grandes au sein de chaque base de données partitionnée.
Dans ce modèle, chaque fragment représente une unité relativement autonome, résiliente et optimisée en interne. La croissance du système est progressive et contrôlée, avec l'ajout de nouveaux fragments selon les besoins et le maintien de performances prévisibles dans le temps.
Ce type d'architecture est typique des grands sites de commerce électronique, des plateformes à fort trafic, des services SaaS d'entreprise et des infrastructures d'hébergement avancées, où l'évolutivité doit être planifiée mais aussi gérée avec soin.
Implications pour le monde de l'hébergement et des CMS
Dans l'univers des CMS comme WordPress, WooCommerce, Magento et PrestaShop, la réplication est souvent la solution la plus immédiate et efficace pour améliorer la fiabilité et les performances. Relativement simple à mettre en œuvre, elle ne nécessite aucune modification invasive de l'application et résout de nombreux problèmes courants liés à l'augmentation du trafic.
Le partitionnement est moins fréquent dans ces contextes, mais il peut apporter des avantages considérables aux bases de données qui ont pris de l'ampleur au fil du temps, notamment pour les tables contenant les commandes, les journaux, les statistiques et les données historiques. Correctement appliqué, il permet d'améliorer les performances sans nécessiter d'intervention sur l'infrastructure.
Le partitionnement, en revanche, exige des modifications de l'application et une conception plus approfondie. Il ne s'agit pas d'une solution prête à l'emploi et elle doit être soigneusement évaluée, notamment pour les systèmes de gestion de contenu traditionnels qui ne sont pas conçus nativement pour une architecture distribuée.
C’est pourquoi, dans le domaine de l’hébergement géré, la véritable différence ne réside pas dans la technologie elle-même , mais dans l’expertise système qui la met en œuvre. Savoir s’arrêter, optimiser et repenser l’architecture, voilà ce qui distingue une infrastructure capable de soutenir la croissance d’une infrastructure qui s’effondre sous le poids de son succès.
Conclusions
La réplication, le partitionnement et le sharding ne sont pas des alternatives, mais des outils complémentaires répondant à différents besoins et à différentes phases du cycle de vie d'un projet. Les considérer comme des solutions interchangeables est l'une des erreurs les plus fréquentes dans la conception d'architectures de bases de données modernes.
La réplication est la solution idéale lorsque la priorité est la disponibilité du service et la continuité des activités, même en cas de panne. C'est une solution efficace pour améliorer la résilience de l'infrastructure et répartir la charge de lecture, sans perturber l'architecture applicative existante.
Le partitionnement devient essentiel lorsque la base de données s'agrandit et que certaines tables atteignent une taille telle qu'elles nuisent aux performances. Dans ce cas, il n'est pas nécessaire d'ajouter des serveurs, mais plutôt de mieux organiser les données , ce qui permet de réduire le coût des requêtes et de simplifier la gestion de l'historique.
Le partitionnement représente l'étape la plus complexe, mais aussi la plus efficace. Face à une croissance structurelle du système , lorsque le volume de données et la charge d'écriture dépassent les capacités d'un seul nœud, le partitionnement devient incontournable. Ce choix architectural exige une réflexion approfondie, une planification rigoureuse et des compétences pointues, mais il permet de construire des systèmes véritablement évolutifs sur le long terme.
Savoir quand faire une pause et quand faire évoluer l'architecture, voilà ce qui distingue un système performant d'un système qui s'effondre sous le poids de sa propre charge. Il n'existe pas de solution universelle, mais toujours un choix judicieux en fonction du contexte, des données réelles et des objectifs du projet.
Et c’est précisément à ce stade qu’une conception systémique consciente fait toute la différence, transformant la croissance, d’un problème à gérer, en une opportunité à pérenniser.

