
Table des matières de l'article :
Il arrive que les migrations aboutissent au résultat escompté. Le client, quittant un hébergeur incapable de garantir des temps de réponse adéquats, migre vers une infrastructure plus performante et de pointe comme la nôtre, met en place une architecture serveur optimisée pour WordPress et WooCommerce, et le problème disparaît.
Eh bien, celle que je vais vous raconter n'est PAS une de ces histoires.
Dans ce cas précis, le client, auparavant hébergé chez un autre fournisseur, se plaignait de problèmes importants de performance web : temps de chargement insatisfaisants et comportement du site difficile à expliquer par rapport au trafic réel . Il s’agissait d’un site e-commerce WooCommerce, et lors de la migration vers Managed Server Srl, la conviction initiale était simple : en transférant le site vers une infrastructure correctement dimensionnée et notre architecture serveur optimisée, la plupart, voire la totalité, des problèmes disparaîtraient.
Le client le pensait aussi (après tout, nous sommes réputés pour cela).
Nous le pensions aussi.
Eh bien, nous avions tous les deux tort !
La nouvelle infrastructure était largement suffisante. NGINX, PHP-FPM, MariaDB, les caches applicatifs comme Redis d'Object Cache et les caches HTTP comme le réputé Varnish Cache étaient configurés pour gérer des charges bien supérieures aux performances réelles du site. Pourtant, quelque chose clochait. Plus important encore, une charge CPU massive persistait alors que, compte tenu du trafic, elle n'aurait tout simplement pas dû se produire.
Ce qui semblait au départ être un travail normal de migration et d'optimisation de système s'est transformé en quelque chose qui, en théorie, devrait se trouver de l'autre côté de la barrière : un véritable débogage d'application au sein de WordPress, WooCommerce et du thème Woodmart.
C’est précisément là qu’un service géré présente une différence significative par rapport à un simple hébergement. Lorsque les graphiques montrent que le serveur fonctionne, que la base de données n’est pas saturée, que le stockage n’est pas en attente, que le réseau n’est pas congestionné et que le cache n’explique pas le problème, il est inutile de modifier indéfiniment les paramètres PHP en espérant que le problème disparaisse.
À un moment donné, il faut se salir les mains.
La migration avait résolu le problème du serveur, pas celui du problème de fond.
L'environnement sur lequel le problème a été analysé disposait de 8 vCPU et de 64 Go de RAM , avec AlmaLinux 9.8, NGINX, PHP-FPM 8.3.32, MariaDB, WordPress 7.0.3, WooCommerce 10.9.3 et Woodmart 8.1.2. Le catalogue comportait 479 produits publiés et l'installation utilisait 28 plugins actifs.
Autrement dit, il ne s'agissait pas d'un site WooCommerce de grande envergure hébergé sur un VPS sous-dimensionné. Il ne s'agissait pas non plus d'un serveur constamment sollicité par des échanges de données ou en attente d'espace de stockage.
Le fait le plus important était autre chose.
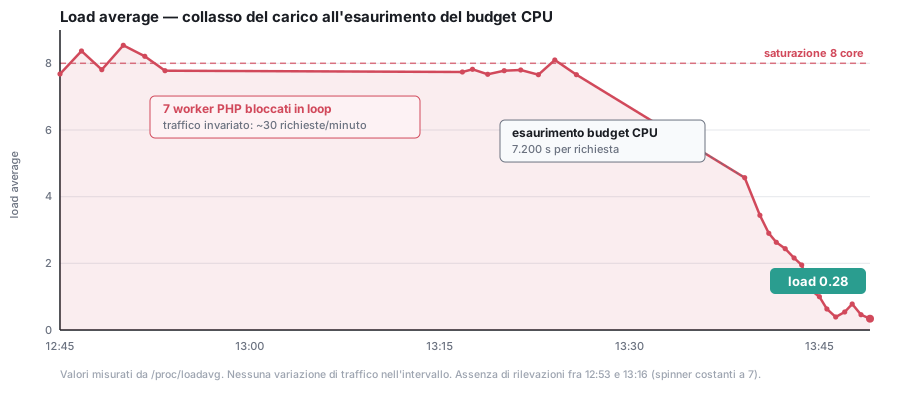
Avec un trafic d'environ 30 requêtes par minute , y compris les ressources statiques, le serveur a enregistré une charge moyenne constamment de l'ordre de :
7.70 / 7.83 / 7.90
sur une machine à 8 cœurs dont le processeur est utilisé à 100 %.
La répartition du temps processeur était encore plus intéressante :
- 88,5 % des utilisateurs;
- système à 1,4 % ;
- 0,0 % iowait.
Ce fait vaut plus que bien des suppositions.
Si une machine attend un accès disque, on observe généralement des interruptions d'E/S. Si la base de données constitue le goulot d'étranglement, on constate généralement des requêtes, des verrous, des attentes, des E/S, des connexions ou d'autres signes similaires. Si le problème est lié au réseau, on observe un ensemble de signaux différents. Ici, cependant, la quasi-totalité du temps a été consommée par l'espace utilisateur du processeur.
Le processeur exécutait du code.
Beaucoup de code.
Et il ne s'attendait pratiquement à rien.
Cette distinction est cruciale car elle permet d’éviter l’une des erreurs les plus courantes dans le dépannage des performances de WordPress : confondre toute lenteur avec un problème d’hébergement.
L'hébergement peut être lent. Une base de données peut être mal configurée. PHP-FPM peut manquer de puissance. Le stockage peut être insuffisant. La mise en cache peut être absente. Ce sont tous des problèmes bien réels.
Mais lorsque sept cœurs effectuent des calculs PHP de manière quasi continue pour un site qui reçoit très peu de requêtes, l'ajout de matériel ne fait que permettre au bug de consommer davantage de ressources.
Première erreur de perspective : croire que le cache était suffisant
Sur serveur géré, nous utilisons généralement plusieurs niveaux de cache précisément parce que sur WordPress et WooCommerce, il est essentiel d'éviter de devoir reconstruire l'intégralité de la page via PHP et la base de données à chaque accès.
Le cas analysé comportait plusieurs couches : le cache proxy NGINX configuré en microcache, Varnish et le cache d’objets Redis. Lors du débogage, ces couches ont été progressivement désactivées afin d’éliminer les variables de l’analyse.
Nous avons cependant découvert un autre détail intéressant : Un cache périphérique est resté actif.L'en-tête bestcache.io: STALE et une page d'accueil renvoyée en seulement 15 à 40 millisecondes a démontré que certaines des premières mesures, apparemment « sans cache », n'interrogeaient pas directement l'origine.
Les mesures ont ensuite été répétées en utilisant des URL structurellement non mises en cache et des outils de contournement du cache.
Mais le véritable problème conceptuel était tout autre, et il était impensable !
Un cache peut empêcher l'exécution d'une tâche. Il ne peut pas interrompre une tâche infinie.
Le modèle peut être simplifié comme suit :
carico origin ≈ richieste × miss rate × costo del MISS
Presque toutes les optimisations de cache fonctionnent sur le deuxième facteur : le taux d'échec.
Si la génération d'une page prend 400 millisecondes et que nous la servons depuis le cache dans 99 % des cas, nous obtenons d'excellents résultats. Le serveur d'origine paie rarement ces 400 millisecondes, et toutes les autres requêtes sont traitées à un coût quasi nul.
Mais que se passe-t-il si le coût de l'erreur n'est pas de 400 millisecondes ?
Que se passe-t-il si le MISS entre dans un cycle qui ne se termine pas ?
Le modèle change complètement.
Le raté qui ne devient jamais un succès
Un cache HTTP ne peut stocker une réponse qu'une fois celle-ci produite.
Cela peut paraître évident, mais c'est précisément ce détail qui a rendu cet incident particulièrement insidieux.
La séquence était la suivante :
- une requête arrive pour une page produit spécifique ;
- Le cache ne contient pas l'objet et enregistre une erreur MISS ;
- la requête est transmise à PHP ;
- Lors du rendu, PHP intègre le code de navigation produit précédent/suivant de Woodmart ;
- le code entre dans une boucle ;
- la requête ne s'arrête pas ;
- Aucune réponse HTTP complète n'est produite ;
- le cache, n'ayant reçu aucune réponse, Il n'a rien à mémoriser.;
- La requête suivante adressée à la même ressource échoue à nouveau.
Par conséquent, le passage fondamental n'existe pas :
ÉCHEC → rendu → réponse → objet mis en cache → requêtes suivantes.
Le processus se bloque à mi-chemin :
MANQUER → PHP → boucle.
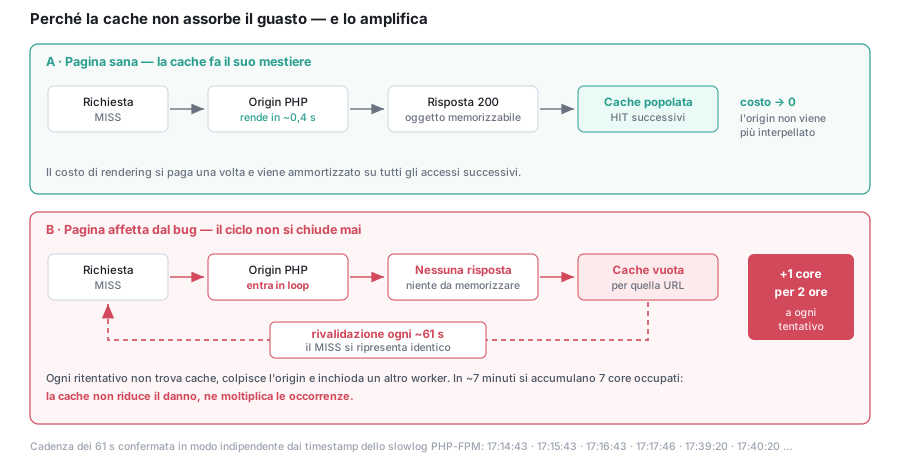
Une page fonctionnelle génère une réponse pouvant être mise en cache. La page affectée ne termine pas son rendu : aucun objet n’est créé et chaque nouvelle tentative sollicite à nouveau PHP.
C'est l'une des leçons les plus importantes de toute cette affaire.
La mise en cache ne corrige pas la complexité pathologique du code applicatif.
Cela peut le masquer. Cela peut réduire la fréquence à laquelle nous y sommes confrontés. Mais si, pour une raison ou une autre, une requête doit effectivement atteindre l'origine, le coût réel de l'application refait immédiatement surface.
Lorsque le cache cesse de protéger et commence à amplifier
Le plus intéressant dans cette affaire, c'est que l'un des mécanismes habituellement utilisés pour renforcer la robustesse d'un site a fini par contribuer à la génération automatique de charge.
Les journaux contenaient des requêtes provenant de 127.0.0.1 vers l'URL problématique à intervalles extrêmement réguliers : à propos de 61 secondes.
Les horodatages détectés lors de l'analyse ont montré des séquences comme :
17:14:43 · 17:15:43 · 17:16:43 · 17:17:46 · 17:39:20 · 17:40:20 · 17:41:23 · 17:42:23
Une telle périodicité est compatible avec un mécanisme de revalidation automatique.
Et voici le paradoxe.
Le système tente de revalider une ressource. Ne la trouvant pas disponible dans le cache, il contacte PHP. PHP entre dans une boucle. La revalidation ne reçoit pas de nouvelle réponse valide. Peu après, une autre revalidation démarre. Celle-ci contacte également PHP et utilise un autre processus.
Chaque tentative ajoute un processus qui consomme la quasi-totalité d'un cœur du système.
Le cache, conçu pour décharger l'origine, s'est donc comporté comme un générateur périodique du problème dans ce mode de défaillance particulier.
Non pas parce que le cache était mal configuré au sens traditionnel du terme, mais parce que l'application n'était plus en mesure de satisfaire le contrat fondamental sur lequel repose un cache : recevoir une requête et, tôt ou tard, renvoyer une réponse.
Sept processus PHP, sept cœurs presque entièrement occupés
L'inspection des procédés PHP-FPM a immédiatement permis de séparer deux populations de travailleurs.
D'un côté, il y avait les processus normaux, avec des dizaines de secondes d'utilisation du processeur accumulées sur de nombreuses heures.
En revanche, certains processus, bien que nés dans le même intervalle de temps, avaient accumulé des milliers de secondes de temps CPU.
Échantillonnage direct de /proc/PID/stat, réalisées à intervalles de dix secondes, ont permis de quantifier le comportement : les sept processus anormaux ont consommé environ 98 % de chaque noyau en continu.
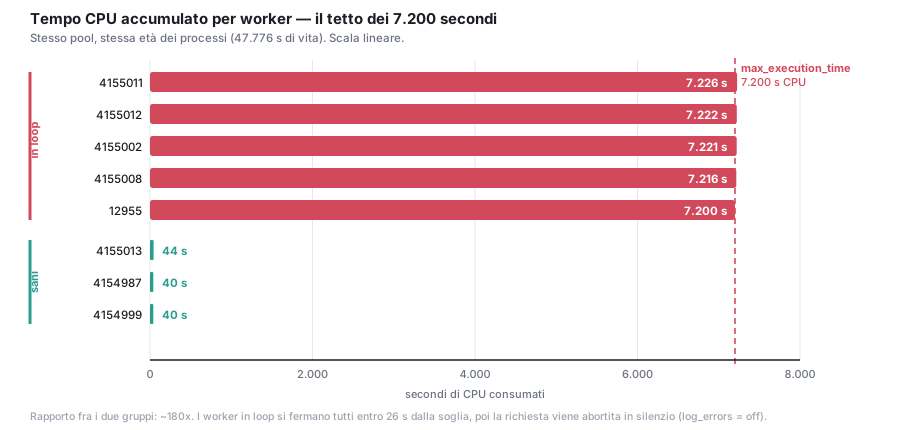
Sur une machine à huit vCPU, cela signifie concrètement ne laisser qu'un seul cœur pour le reste du système.
Il est également utile ici d'examiner la configuration de PHP-FPM :
pm = static
pm.max_children = 32
request_terminate_timeout = 7200
php_admin_value[max_execution_time] = 7200
php_admin_flag[log_errors] = off

; nessun pm.status_path
; nessuno slowlog
La configuration autorisait jusqu'à 32 processus PHP simultanés, mais cela ne correspond évidemment pas à 32 cœurs . Si sept processus tiennent sur un cycle CPU d'une machine à huit cœurs, la capacité de calcul disponible est déjà presque entièrement utilisée.
De plus, les deux request_terminate_timeout que max_execution_time étaient prêts à secondes 7200.
Deux heures.
Cela signifie qu'une seule requête pathologique pourrait théoriquement consommer 7200 secondes de temps processeur, soit un cœur pendant deux heures , avant d'être interrompue.
Nous ne parlons pas d'une page qui met quatre ou cinq secondes à se charger.
Nous parlons d'une demande qui peut se transformer en deux heures de travail inutile.
Pourquoi Redis n'a rien pu résoudre
En matière de lenteur de WooCommerce, Redis est souvent présenté comme une solution universelle.
Redis est très utile, mais il faut comprendre quel problème il résout.
Un cache d'objets réduit le coût de récupération des objets, options, résultats et données qui nécessiteraient autrement des accès répétés à la base de données. Si une application exécute de nombreuses requêtes identiques ou reconstruit constamment les mêmes objets, Redis peut s'avérer très performant.
Dans notre cas, cependant, nous avions :
0,0% iowait.
De plus, la mémoire RSS des processus concernés est restée identique à l'octet près, même après plusieurs dizaines de minutes . Un des échantillons rapportés, par exemple :
635436 kB → 635436 kB
Aucune croissance.
Aucune nouvelle allocation significative.
Aucune activité d'E/S compatible n'a été détectée avec une charge de travail qui continuait d'interroger une base de données.
Le processus s'exécutait sur des données déjà présentes en mémoire.
Il s'agissait d'un cycle de contrôle qui n'a pas progressé.
Dans ce cas, Redis est indépendant du problème. Il peut accélérer la récupération des données utilisées avant l'entrée dans la boucle, mais une fois la boucle infinie enclenchée, aucun cache d'objets n'est capable de faire progresser la variable qui devrait déclencher la condition de sortie.
Ce n'était pas MariaDB, ce n'était pas OPcache, ce n'était pas wp-cron
Un débogage sérieux ne consiste pas à trouver rapidement un coupable plausible.
Il s'agit avant tout d' éliminer méthodiquement tous les coupables plausibles qui ne sont pas responsables.
Plusieurs hypothèses ont été testées au cours de l'analyse.
Le planificateur d'actions n'avait que 22 actions en attente et aucune en cours. La synchronisation complète de Jetpack n'était pas bloquée. OPcache affichait un taux d'accès de 99,73 % , sans redémarrage pour cause de mémoire insuffisante ni de hachage. Les options de chargement automatique occupaient environ 0,56 Mo répartis sur 1 493 lignes, une valeur incompatible avec l'explication de la charge observée. Aucune planification récurrente n'avait d'intervalle nul.
Même l'hypothèse d'un réseau de bots qui a atteint certains paramètres ?per_row= Elle a été exclue car ces demandes avaient reçu une réponse. 444 directement au niveau NGINX, sans atteindre PHP.
La base de données ne présentait pas la saturation attendue en cas de problème SQL et, comme mentionné, le système enregistrait un taux d'attente d'E/S de 0 %.
L'analyse d'une page fonctionnelle a également montré que le démarrage complet du plugin ne constituait pas une anomalie majeure. Une requête de test s'est terminée après le chargement des mu-plugins en environ 0,934 seconde, avec 332 requêtes et une consommation mémoire maximale de 48 Mo.
Certaines valeurs ont été détectées :
core:wp-includes                                     0,136 s
plugins:yith-woocommerce-advanced-reviews-premium   0,094 s
plugins:woocommerce                                  0,070 s
plugins:woocommerce-paypal-payments                  0,019 s
plugins:wordpress-seo                                0,012 s
Aucun plugin n'a affiché de coût susceptible d'expliquer l'utilisation continue de sept cœurs.
Ces tests sont également importants d'un point de vue méthodologique.
Nous aurions pu désactiver les plugins au hasard, constater une baisse temporaire de la charge ou un changement de comportement, attribuer la cause à une corrélation accidentelle et en rester là.
Ce n'est pas notre façon de travailler.
Une cause est une cause lorsqu'il existe une chaîne de preuves reproductibles reliant le symptôme au code responsable.
La comparaison qui excluait définitivement l'infrastructure
Une autre découverte particulièrement significative provient d'un deuxième pool PHP hébergé sur le même serveur.
Même système d'exploitation.
Même NGINX.
Même PHP.
Même MariaDB.
Même machine physique ou virtuelle sous-jacente.
Les processus de ce groupe affichaient une utilisation totale du processeur d'environ 57 à 62 secondes, contre plus de 5 000 secondes accumulées par les processus WooCommerce atypiques que nous avons analysés.
Si le problème avait concerné le noyau, la virtualisation, le processeur physique, le stockage, MariaDB ou la configuration générale de l'hôte, il aurait été difficile d'expliquer une séparation aussi nette entre deux charges de travail partageant la même infrastructure.
Le problème a suivi le site.
Et lorsqu'un problème se situe dans le code et non dans le serveur, il faut cesser de régler le serveur et commencer à examiner le code.
Problème suivant : nous ne disposions pas des outils habituellement utilisés pour ce type de travail.
Identifier que le problème provenait d'une application ne représentait que la moitié du chemin parcouru.
Il nous fallait maintenant déterminer où PHP consommait toute cette puissance CPU.
Et c'est là que l'incident est devenu particulièrement intéressant.
Les outils standard que nous utilisons habituellement pour inspecter un processus en cours d'exécution étaient soit indisponibles, soit inutilisables dans ce contexte précis.
ptrace, strace e gdb n'a pas pu être utilisé sur les enfants FPM comme prévu. L'extension pcntl Il était absent. Aucun profileur comme XHProf ou Tideways n'était installé.
PHP-FPM n'avait pas été configuré pm.status_path.
Aucun journal des ralentissements n'a été configuré.
Et particulièrement:
log_errors Il a été désactivé.
Le résultat fut quasi parfait pour rendre invisible ce type de problèmes.
Une requête entrait dans la boucle, continuait à consommer du processeur, le client finissait par interrompre la connexion et le processus PHP continuait de s'exécuter jusqu'à expiration du délai de deux heures.
Aucune erreur d'application.
Aucune trace de pile.
Aucun journal PHP utile.
Le numéro 504 ne correspond pas nécessairement à la durée réelle du processus.
Du point de vue de l'observabilité, c'était presque un trou noir.
Nous avons ensuite construit les outils de débogage qui manquaient.
Lorsqu'il est impossible d'observer directement la pile d'exécution d'un processus PHP-FPM en production, il est nécessaire de trouver d'autres moyens d'établir des corrélations :
PID → Requête HTTP → Comportement du processeur → Chemin de l'application.
Trois outils de diagnostic ont donc été temporairement mis en place.
1. Un traceur de requêtes START/END
Le premier était conceptuellement extrêmement simple.
Au début de la requête, l'horodatage, le PID, l'identifiant et l'URI ont été enregistrés. À la fin de la requête, un gestionnaire d'arrêt a enregistré la ligne END correspondante.
@file_put_contents(
$log,
sprintf(
"%s\tSTART\t%d\t%s\t%s\t%s\n",
gmdate('H:i:s'),
getmypid(),
$id,
$method,
$uri
),
FILE_APPEND
);

register_shutdown_function(function () use ($id) {
@file_put_contents(
$log,
sprintf(
"%s\tEND\t%d\t%s\t%.2fs\n",
gmdate('H:i:s'),
getmypid(),
$id,
microtime(true) - $t0
),
FILE_APPEND
);
});
Une requête saine produit alors une paire :
START → END
Une requête bloquée produit en revanche :
START → ...
sans FIN.
Pour extraire les requêtes encore en cours, il a suffi de corréler les deux types d'enregistrements :
awk -F'\t' '$2=="START"{s[$4]=$0} $2=="END"{delete s[$4]} END{for(k in s) print s[k]}' req-trace.log
Ce traceur a isolé quatre requêtes orphelines, toutes centrées sur la même URL.
Et surtout, ces requêtes ont montré la même périodicité que celle observée dans le comportement des processus.
2. Un observateur de spin pour les processus PHP-FPM
Le deuxième instrument a effectué un échantillonnage périodique. /proc/PID/stat.
L'objectif n'était pas de profiler PHP au niveau des fonctions, mais de détecter une condition beaucoup plus simple :
Ce processus monopolise le processeur à près de 100 % sans se terminer ?
Lorsque le système de surveillance détectait un processus en cours d'exécution, il pouvait corréler son PID avec le traceur de requêtes et déterminer quelle requête HTTP était réellement exécutée dans ce processus.
Cette étape a permis d'éliminer une grande partie de l'espace de recherche.
3. Fil d'Ariane et traces d'exécution directement depuis l'application
Le troisième instrument est celui qui a définitivement clos l'affaire.
Comme nous ne pouvions pas interroger facilement le processus depuis l'extérieur, nous avons fait en sorte que l'application elle-même prenne un instantané de sa propre pile pendant que la boucle était en cours d'exécution.
Un dispositif global comptabilisait les exécutions et, lorsque certains seuils étaient atteints, acquérait un debug_backtrace().
add_action('all', function () {
$n = ++$GLOBALS['__bc_n'];

```
if ($n === 20000 || $n === 80000 || $n === 200000) {
    $bt = debug_backtrace(
        DEBUG_BACKTRACE_IGNORE_ARGS,
        80
    );

    // Serializzazione diagnostica su file.
}

if ($n > 200000) {
    exit('diagnostic abort');
}
```

});
Le résultat était impressionnant.
En une seule requête, le fil d'Ariane a atteint 300 000 points d'ancrage en environ 4,2 secondes.
L'hameçon alloptions a été invoqué 26.684 fois.
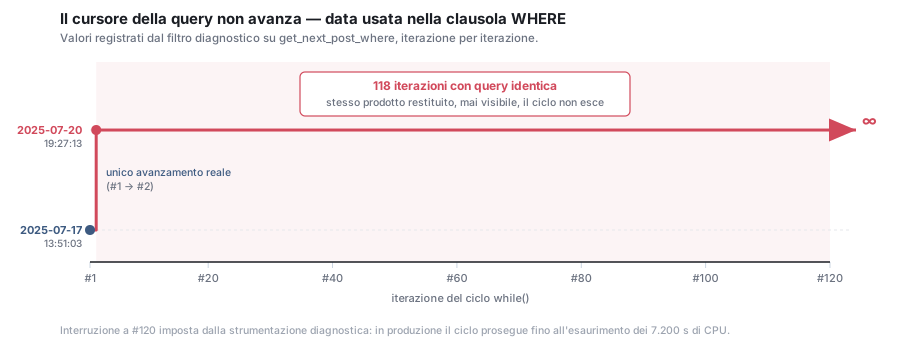
À ce stade, nous n'envisagions plus l'hypothèse d'une boucle.
Nous le surveillions.
La trace de la pile mène directement à Woodmart
La trace d'exécution enregistrée pendant la boucle a montré la séquence suivante :
#5  wc_get_product()
themes/woodmart/.../class-adjacent-products.php:92

#6  WC_Adjacent_Products->get_product()
themes/woodmart/.../functions.php:588

#7  woodmart_get_next_product()
themes/woodmart/woocommerce/single-product/navigation.php:13

#8  wc_get_template()
themes/woodmart/woocommerce/content-single-product.php:203

#9  load_template()
wp-includes/template.php:816
Le chemin était désormais parfaitement dégagé.
Nous n'assistions pas à un passage en caisse.
Nous n'avons pas constaté de requêtes produit particulièrement importantes.
Nous n'envisagions ni un appel REST, ni une tâche cron, ni une synchronisation.
La boucle s'est produite lors de la création de la navigation produit précédente/suivante du thème Woodmart .
Entre-temps, le journal des ralentissements de PHP-FPM a également été activé, à titre de vérification indépendante.
Su 24 traces de pile acquises, 24 contenaient woodmart_get_next_product.
Deux outils différents, basés sur des mécanismes différents, sont arrivés exactement au même point.
Voilà la différence entre une supposition et un diagnostic.
Le code qui ne pouvait plus sortir de la boucle
Le point crucial se trouvait dans le fichier :
wp-content/themes/woodmart/inc/integrations/woocommerce/modules/class-adjacent-products.php
La structure pertinente de la méthode était la suivante :
public function get_product() {
global $post;

```
$product               = false;
$this->current_product = $post->ID;

while ( $adjacent = $this->get_adjacent() ) {
    $product = wc_get_product( $adjacent->ID );

    if ( $product && $product->is_visible() ) {
        break;
    }

    $product               = false;
    $this->current_product = $adjacent->ID;
}

if ( $product ) {
    return $product;
}

return false;
```

}
L'intention du code est compréhensible.
À partir du produit actuel, on recherche le produit adjacent. Si le produit trouvé est visible, il est renvoyé et la boucle se termine. Sinon, il est ignoré, la référence actuelle est mise à jour et la recherche continue.
Conceptuellement :
prodotto corrente → adiacente → è visibile? → sì: break / no: continua
Le problème est toutefois apparu avec une configuration de données particulière : deux produits consécutifs ont été publiés mais exclus du catalogue.
Dans ces conditions, le mécanisme de recherche de produits adjacents pourrait se retrouver dans une situation où la boucle n'atteint plus une condition de sortie valide.
La navigation n'a donc pas pu converger vers un produit visible ni vers la fin de la séquence.
La méthode continuait à rappeler la logique de recherche et à reconstruire les objets impliqués.
Il n'y avait pas de limite maximale au nombre d'itérations.
Une boucle while sans limite de sécurité n'est correcte que si l'on peut démontrer qu'à chaque itération, l'état évolue nécessairement vers un état terminal.
Dans le cas observé, cette propriété n'était pas garantie.
Le bug ne ralentissait pas la page : il rendait la requête non terminable.
Il est important d'utiliser la terminologie correcte.
Dire que « Woodmart ralentissait WooCommerce » serait une description techniquement faible.
Nous ne mesurions pas une fonction qui prenait deux secondes au lieu de cent millisecondes.
Nous ne mesurions même pas une requête SQL à optimiser.
Nous étions confrontés à un problème de terminaison.
La requête pourrait se poursuivre jusqu'à la limite imposée en externe par PHP-FPM.
Dans notre environnement, cette limite était de 7 200 secondes.
Pour cette raison, le coût unitaire d'une seule demande d'analyse pathologique pourrait atteindre :
7 200 secondes de processeur.
Un noyau.
Pendant deux heures.
Et quelques requêtes de ce type, même générées automatiquement à environ une minute d'intervalle, suffisaient à transformer une machine pratiquement vide en une machine proche de la saturation.
Parce que la circulation semblait inoffensive
Cette dynamique explique également un autre aspect du problème qui pouvait sembler contre-intuitif au premier abord.
Le client a constaté une charge serveur importante malgré un trafic très faible.
On a généralement tendance à corréler la charge avec le nombre de requêtes :
Plus de visites → plus de PHP → plus de requêtes → plus de CPU.
Ici, la corrélation était complètement différente.
Une requête saine peut coûter quelques centaines de millisecondes.
Une demande d'analyse pathologique pourrait coûter 7 200 000.
À ce stade, le simple comptage des requêtes par minute perd presque tout son sens.
Dix mille accès au cache peuvent peser moins qu'une seule requête entrant en rotation du processeur.
C’est l’une des raisons pour lesquelles évaluer un service d’hébergement uniquement sur la base du « nombre de visites qu’il peut gérer » est souvent un critère dénué de sens technique.
Vous devez savoir combien coûte une requête.
Solution : Empêcher les produits non visibles d’entrer dans le chemin et introduire une limite
La solution adoptée a consisté à ne pas augmenter davantage la puissance du serveur.
Cela n'aurait pas eu de sens.
Nous avons introduit un mu-plugin qui intervient sur la logique responsable de la sélection, avec deux principes de sécurité.
Le premier objectif est d'empêcher que les produits invisibles qui génèrent l'état pathologique soient continuellement proposés comme candidats par la recherche SQL.
La seconde consiste à introduire de toute façon une limite maximale aux itérations.
Ce deuxième point est particulièrement important d'un point de vue défensif.
Même si nous pensons avoir corrigé la condition spécifique qui génère la boucle, un code qui parcourt une séquence d'éléments externes doit avoir une limite raisonnable lorsque la terminaison n'est pas mathématiquement garantie.
Le concept, en version simplifiée, est le suivant :
$iterations = 0;
$max_iterations = 100;

while ( $adjacent = get_adjacent_product() ) {

```
if ( ++$iterations > $max_iterations ) {
    return false;
}

$product = wc_get_product( $adjacent->ID );

if ( $product && $product->is_visible() ) {
    return $product;
}

// Avanzamento al candidato successivo.
```

}
Cet exemple illustre le principe de sécurité : aucune navigation « produit précédent/suivant » ne doit consommer indéfiniment un processus PHP.
La solution effectivement appliquée dans ce cas a également déplacé une partie de la protection en amont, ce qui a eu pour conséquence d'exclure de la sélection SQL les produits qui ne pouvaient pas être utilisés pour cette navigation.
De cette façon, vous corrigez les deux niveaux du problème :
Cela évite d'alimenter la boucle avec des candidats invalides et empêche une future anomalie de se transformer en boucle infinie.
Résultat : la charge est passée de 7,70 à 0,28.
Après l'application du correctif, le comportement du système a immédiatement changé.
La charge moyenne est passée d'environ :
7,70 à 0,28.
Nous n'avons ajouté aucun processeur.
Nous n'avons pas augmenté la RAM.
Nous n'avons pas changé le processeur.
Nous n'avons pas remplacé MariaDB.
Nous avons réintégré à la machine environ sept cœurs qui effectuaient un travail inutile.
Le TTFB mesuré sur l'itinéraire concerné s'est également amélioré de manière significative, passant d'environ 1,17 seconde à 0,36 seconde.
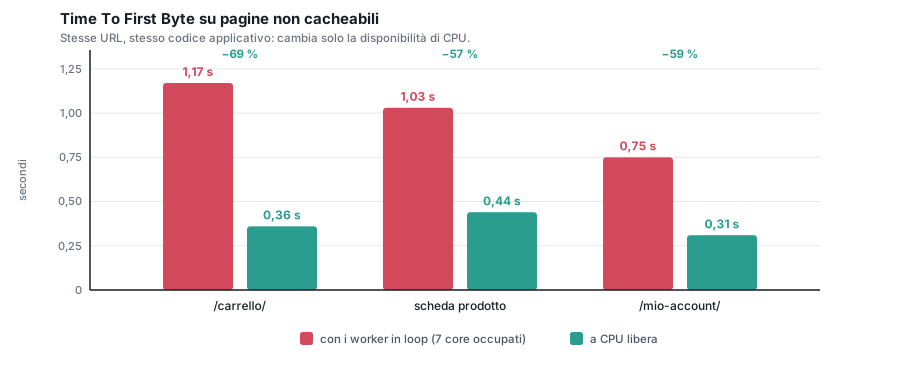
Toutefois, ces données doivent être interprétées correctement.
Le véritable résultat n'est pas une amélioration de quelques centaines de millisecondes sur une seule page.
Le résultat concret est que l'ensemble du système a cessé de perdre de la capacité de calcul au fil du temps.
Avant la correction, chaque nouvelle requête concernée pouvait monopoliser un worker et, de fait, un cœur du service pendant une durée très longue.
Après la correction, cette requête est redevenue une requête WooCommerce normale : elle a démarré, a effectué sa tâche et s’est terminée.
Le plus dangereux avec les bugs d'application, c'est qu'ils ressemblent souvent à des problèmes d'hébergement.
Ce cas illustre parfaitement un problème que nous rencontrons périodiquement dans notre travail.
Un site est lent et le premier suspect devient le serveur.
La mémoire RAM a été augmentée.
Le nombre de processeurs a été augmenté.
Redis est installé.
On ajoute du vernis.
Cela augmente pm.max_children.
Des délais d'attente sont dépassés.
Nous allons migrer vers un serveur encore plus puissant.
Et parfois, le site semble même fonctionner mieux, car nous avons simplement augmenté la quantité de ressources que le défaut peut consommer avant que l'utilisateur ne remarque la saturation.
Mais il ne s'agit pas d'optimisation.
C'est la dissimulation par l'habileté.
Si une boucle consomme un cœur, une machine à 4 cœurs plantera plus rapidement qu'une machine à 32 cœurs. Cela ne signifie pas pour autant que le code exécuté sur la machine à 32 cœurs est correct.
Cela signifie simplement qu'il peut exécuter plusieurs boucles simultanément avant de manquer de ressources CPU.
Nous aussi étions partis d'une mauvaise hypothèse
Il convient de le souligner car, dans une étude de cas technique, se contenter de rapporter les points sur lesquels on a raison est peu utile.
Lorsque le client est passé d'un serveur géré, nous avons également pensé qu'il était raisonnable de s'attendre à ce que le changement d'infrastructure résolve la plupart des problèmes de performance.
Ce n'était pas une hypothèse absurde.
De nombreux sites WooCommerce que nous recevons proviennent en réalité d'environnements avec une configuration PHP mal configurée, un espace de stockage insuffisant, des bases de données non optimisées, une absence de cache d'objets, des serveurs Web génériques, des limites trop basses ou des ressources partagées de manière agressive.
Dans ces cas-là, la migration produit immédiatement une amélioration notable.
Dans ce cas, non.
La nouvelle pile a en revanche fait quelque chose d'aussi utile : elle a supprimé un certain nombre de variables d'infrastructure et a rendu beaucoup plus évident que le comportement résiduel n'était pas normal.
Quand on sait que le serveur peut gérer ce trafic sans difficulté, mais qu'on constate tout de même que sept cœurs sont utilisés à 98 %, la question change.
Ne posez plus de questions :
Comment rendre PHP plus rapide ?
Interroger:
Que fait exactement PHP avec ces sept cœurs ?
Et c'est cette question qui nous a menés à la solution.
L'hébergement géré doit-il se limiter à PHP ?
Nous abordons ici également la question de la responsabilité opérationnelle.
En théorie, un hébergeur pourrait s'arrêter bien plus tôt ; en fait, selon nos collègues très respectés, un hébergeur ne devrait pas aller plus loin.
Vous pourriez montrer aux clients les graphiques, démontrer que le matériel fonctionne, souligner que la consommation provient des processus PHP du site et répondre :
Il s'agit d'un problème lié à l'application, veuillez contacter le développeur.
Dans de nombreux contrats, il s'agirait même d'une réponse légitime.
Mais un service qui se prétend véritablement géré , surtout lorsqu'il travaille spécifiquement avec WordPress et WooCommerce, doit au moins être capable de comprendre où s'arrête l'infrastructure et où commence l'application.
Et dans certains cas, cette limite doit être franchie, surtout si l'on possède l'expérience et les compétences nécessaires, sachant que très peu de développeurs en sont capables aujourd'hui.
Cela ne signifie pas pour autant qu'une société d'hébergement doive devenir l'agence de développement du client.
Cela signifie que lorsqu'une anomalie d'application met l'infrastructure en danger, l'ingénierie système et le débogage d'applications deviennent deux aspects d'un même problème.
Un processus PHP est simultanément :
- un processus du système d'exploitation ;
- un worker PHP-FPM ;
- une requête HTTP ;
- une exécution WordPress ;
- un ensemble de crochets ;
- Code du plugin et du thème ;
- Requête WooCommerce ;
- État de la demande.
S’arrêter artificiellement à un seul de ces niveaux revient souvent à ne pas expliquer ce qui se passe réellement.
C'était Woodmart le coupable !
Il est également important d'éviter les généralisations erronées.
Le diagnostic concerne la version Woodmart 8.1.2 présente dans l'installation analysée et une combinaison spécifique de code, d'état du catalogue et de produits publiés mais exclus de la visibilité.
Il serait absurde de conclure que « Woodmart est lent », c'est-à-dire « toujours lent », ou que tout site utilisant ce thème est sujet au même comportement.
La valeur technique de l'affaire est une autre question.
Un composant populaire peut contenir un chemin marginal qui fonctionne parfaitement pour des millions de requêtes et qui échoue uniquement lorsqu'il rencontre une combinaison particulière de données.
C’est précisément pour cette raison que ces problèmes sont difficiles à reproduire.
Il ne suffit pas d'installer WooCommerce.
Il ne suffit pas d'installer Woodmart.
Ouvrir une page produit ne suffit pas.
Vous avez besoin de la séquence précise de produits et de conditions qui empêchent le code de converger.
En production, cependant, cette combinaison existait bel et bien.
Et cela suffit.
Les leçons systémiques que nous gardons avec nous
Cet accident nous a apporté d'importantes confirmations.
Un excellent taux d'accès au cache ne garantit pas le bon fonctionnement de l'application.
Un cache permet de maintenir la rapidité de l'interface utilisateur même en présence d'un chemin d'accès applicatif anormal. Le problème survient dès la première erreur de requête (MISS), la première invalidation, la première revalidation ou la première requête structurellement non cachable.
La charge moyenne à elle seule ne suffit pas
Un lot de 8 peut signifier des choses complètement différentes.
Vous devez déterminer si le temps est consacré au processeur utilisateur, au processeur système, aux E/S, aux verrous, aux processus exécutables ou à l'attente.
Dans notre cas, 88,5 % des utilisateurs et 0,0 % des temps d'attente d'E/S ont répondu au sondage beaucoup plus rapidement que n'importe quel test de performance synthétique.
Les longs temps morts ne sont pas gratuits.
Un délai d'expiration de 7 200 secondes peut être nécessaire pour certaines opérations administratives ou par lots, mais appliqué sans discernement à un pool Web transforme une boucle d'application en une ressource saisie pendant deux heures.
Un délai d'attente ne corrige pas le bogue, mais il détermine la durée pendant laquelle celui-ci peut nuire au système.
Observabilité avant l'urgence
L'absence de journaux de ralentissement, d'état FPM et d'enregistrement des erreurs rend plus difficile le diagnostic précis des domaines où ces outils seraient les plus utiles.
Dans cette intervention, nous avons réussi à compenser en créant des outils temporaires, mais cela ne devrait pas être la norme.
Une requête sans fin vaut mille suppositions.
La corrélation du début et de la fin des requêtes avec les PID a suffi à transformer un problème apparemment aléatoire en un petit ensemble d'URL et de processus reproductibles.
La comparaison avec une charge de travail saine sur le même hôte est très puissante.
Lorsque deux sites partagent la même infrastructure et qu'un seul présente le problème, on dispose d'un contrôle expérimental naturel qui permet de réduire considérablement l'espace des hypothèses.
La performance web ne se résume pas à cela. Vitaux Web de base
Aujourd'hui, lorsqu'on parle de performances web, on finit souvent par ne parler que de Lighthouse, LCP, INP, CLS, JavaScript, des images WebP ou AVIF et du chargement des polices.
Ce sont des indicateurs importants.
Mais il existe un niveau précédent.
Avant d'optimiser le rendu du navigateur, nous devons nous assurer que l'origine est informatiquement correcte.
Un TTFB élevé peut être dû à un serveur lent.
Cela peut être dû à des requêtes inefficaces.
Cela pourrait être dû à un cache corrompu.
Peut dépendre d'appels HTTP externes.
Ou, comme dans ce cas, il se peut qu'une partie du rendu PHP ne parvienne pas à se terminer du tout.
Optimiser les images et le JavaScript alors que sept cœurs tournaient en boucle dans le navigateur du produit aurait été comme décharger les sièges d'une voiture dont le moteur est bloqué à l'accélérateur.
La différence entre un serveur rapide et un système rapide
Cette expérience illustre parfaitement la philosophie qui guide notre approche de la performance chez Managed Server.
Un serveur rapide ne garantit pas automatiquement un site web rapide.
Le serveur ne représente qu'une seule couche.
Nous pouvons avoir des processeurs modernes, du NVMe, une quantité considérable de RAM, une configuration adéquate de MariaDB, NGINX, Redis, Varnish, Brotli, HTTP/2 ou HTTP/3, et un excellent système de cache.
Mais si le chemin de rendu existe :
Une boucle infinie, une requête d'une complexité inappropriée, un appel distant qui ne se termine pas, un verrouillage d'application, une tâche cron récursive ou une fonction qui parcourt des millions d'éléments inutilement : tôt ou tard, ce comportement apparaîtra.
Les infrastructures peuvent atténuer les conséquences.
Cela ne peut pas modifier la sémantique du code.
Au final, nous n'avons pas seulement rendu le serveur plus puissant : nous avons fait en sorte que l'application cesse de gaspiller ses ressources.
Nous sommes partis d'une situation où le client venait d'une autre société d'hébergement, convaincu qu'une infrastructure plus performante résoudrait le problème.
Nous pensions nous aussi que c'était plausible.
La migration a certes permis de placer le site sur une infrastructure plus adaptée, mais elle a également démontré quelque chose qu'aucun outil de test commercial n'aurait pu montrer :
Le problème fondamental n'était pas la vitesse d'exécution du code par le serveur, mais le fait que, dans certaines conditions, ce code ne s'achevait jamais.
Nous avons suivi la charge depuis les graphiques système jusqu'aux PID.
Des PID aux requêtes HTTP.
Des requêtes aux hooks WordPress.
Des hooks à la pile PHP.
De la pile à la navigation des produits Woodmart.
De la navigation au cycle sans fin.
Et du cycle à la condition particulière du catalogue qui l'a déclenché.
Ce n'est qu'alors qu'une véritable intervention a été possible.
Le résultat final a été une charge réduite de 7,70 à environ 0,28 , un TTFB réduit d'environ 1,17 à 0,36 seconde et, plus important encore, sept cœurs ont repris du service.
Pas grâce à un nouveau serveur.
Pas grâce à un autre cache.
Non pas grâce à un paramètre magique inséré dans php.ini.
Grâce à un débogage.
Et c'est peut-être le point le plus important de toute cette histoire.
Il arrive parfois qu'un hébergement soit limité à l'hébergement d'une seule application.
Il existe d'autres cas où, si vous voulez vraiment comprendre pourquoi une application ne fonctionne pas, vous devez franchir la frontière entre l'ingénierie des systèmes et le développement, suivre les données jusqu'au code et mettre la main à la pâte.
C'était un de ces moments-là.

