

Table des matières de l'article :
Introduction
En matière de sauvegarde de bases de données, l'erreur la plus fréquente consiste à croire que le problème se résume à « posséder une copie ». En réalité, en environnement de production, le véritable enjeu n'est pas seulement la sauvegarde, mais la capacité à restaurer les données au moment précis où elles sont nécessaires. Une sauvegarde nocturne peut suffire dans des cas simples, mais elle devient insuffisante lorsqu'un incident survient en pleine journée : suppression accidentelle d'une table, migration d'application ratée, mise à jour massive effectuée sans clause spécifique. WHERE, une suppression accidentelle par un système de gestion ou un bogue d'application qui corrompt des données déjà présentes.
C’est là qu’intervient PITR ( Point In Time Recovery ) . Avec PostgreSQL, PITR est une fonctionnalité native et éprouvée, extrêmement robuste, basée sur un concept précis : restaurer une sauvegarde physique de base du cluster, puis réappliquer les fichiers WAL (Write-Ahead Log) jusqu’au point temporel souhaité. Le résultat est une base de données restaurée dans l’état cohérent qu’elle avait à un instant précis, par exemple, quelques secondes avant une erreur humaine.
Comparé à un simple pg_dumpLa restauration à un stade précis (PITR) fonctionne différemment. Elle ne consiste pas en l'exportation logique d'une seule table ou base de données, mais en la restauration physique de l'intégralité du cluster PostgreSQL. C'est important : la PITR n'est pas conçue pour restaurer sélectivement une seule table au sein d'une base de données tout en laissant le reste inchangé. Il s'agit plutôt d'une procédure de reprise après sinistre permettant de reconstruire l'environnement PostgreSQL complet à un état antérieur à une date donnée.
Comment fonctionne PITR dans PostgreSQL
Comme de nombreuses bases de données relationnelles modernes, PostgreSQL utilise un système de journalisation appelé journalisation anticipée (WAL ). Avant qu'une modification ne soit considérée comme définitivement enregistrée dans les fichiers de données, PostgreSQL écrit les informations nécessaires dans les journaux WAL. Ce mécanisme garantit la cohérence des données, la récupération après incident, la réplication physique et, bien sûr, la restauration à un point précis dans le temps.
Les WAL (journaux écritures journalisés) sont une séquence ordonnée de segments décrivant les modifications survenues dans le cluster : transactions, insertions, mises à jour, suppressions, modifications d’index et autres opérations internes. Si l’on dispose d’une sauvegarde physique effectuée à un instant donné et de tous les WAL produits depuis, PostgreSQL peut reproduire ces modifications jusqu’à l’obtention de l’état souhaité.
Le schéma logique est simple :
Base backup fisico + WAL archiviati = possibilità di recovery fino a un punto nel tempo
La sauvegarde de base représente le point de départ. Les journaux WAL représentent l'historique suivant. La cible de récupération indique à PostgreSQL où s'arrêter : une date et une heure précises, un identifiant de transaction, un LSN ou un point de restauration nommé.
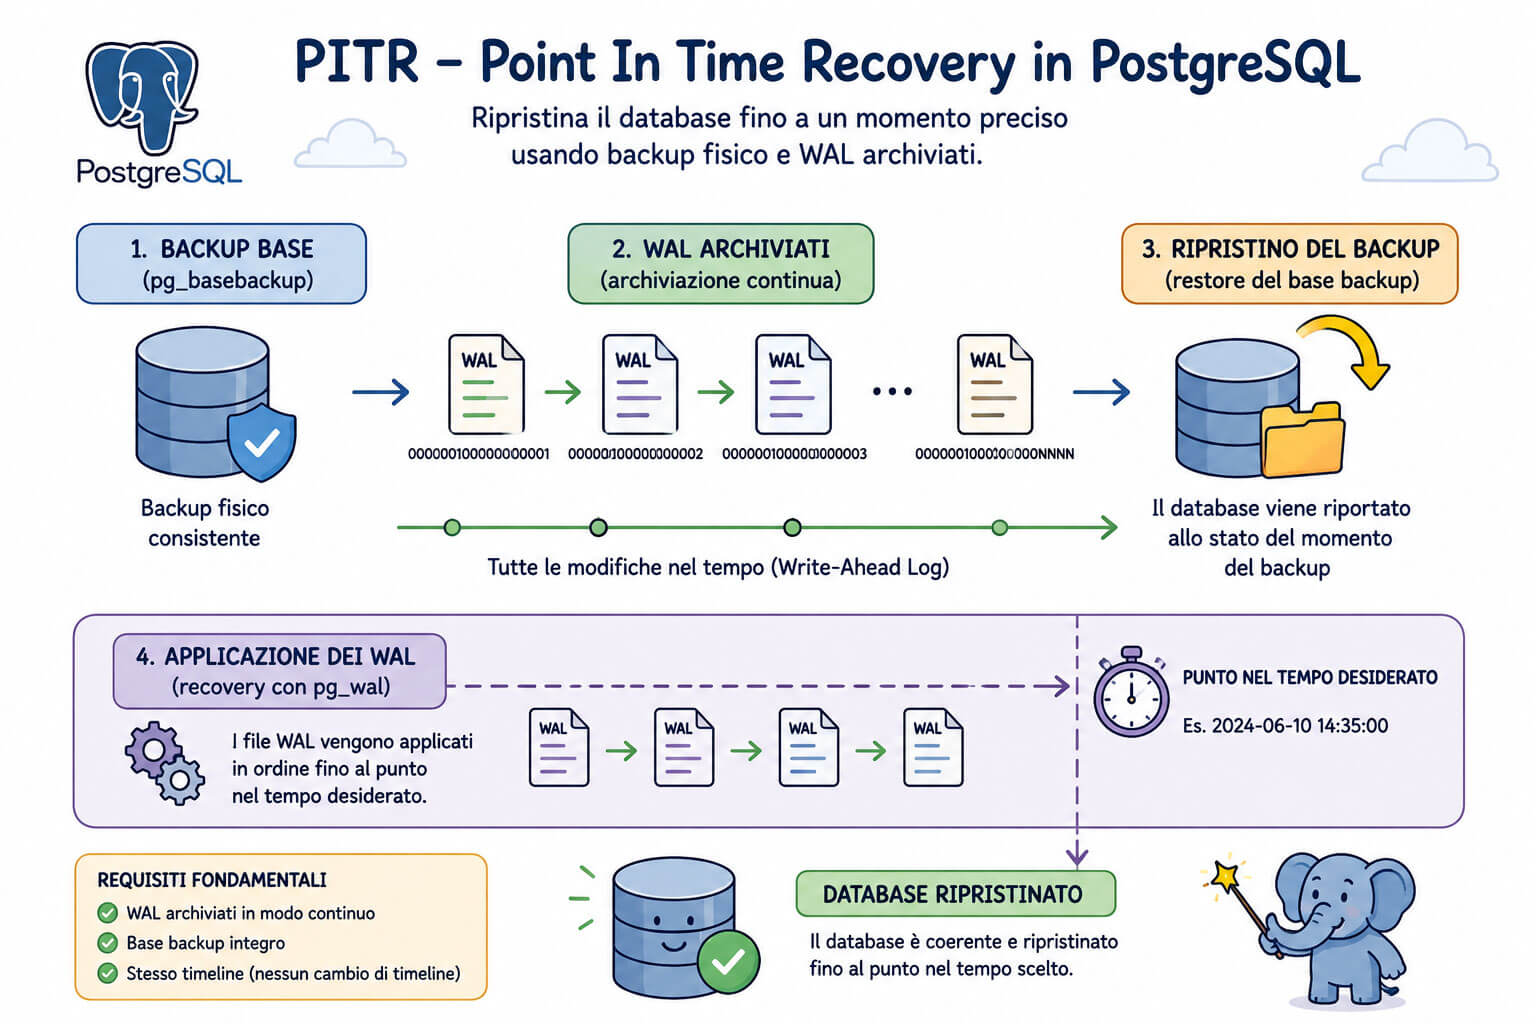
Cette architecture rend PostgreSQL particulièrement adapté aux environnements où l'objectif de point de récupération (RPO) doit être faible. Si les journaux WAL sont archivés correctement et de manière cohérente, la perte de données peut être réduite à quelques secondes, voire à presque zéro dans certains cas, par rapport à la date du dernier journal WAL disponible.
Sauvegarde logique et restauration à la demande : pourquoi pg_dump ne suffit pas
pg_dump e pg_dumpall Ces outils sont essentiels, mais ne conviennent pas à la mise en œuvre d'une restauration à l'intention des utilisateurs (PITR). Ils produisent des sauvegardes logiques, c'est-à-dire une représentation SQL des objets et des données. Ils sont très utiles pour les migrations, les exportations sélectives, les restaurations de bases de données uniques ou la compatibilité entre versions, mais ils ne contiennent pas les informations physiques nécessaires à la réapplication d'une séquence WAL.
Le PITR exige en revanche un sauvegarde physique du clusterCela peut être réalisé avec pg_basebackup, avec des outils spécialisés tels que pgBackRest ou Barman, ou avec des procédures de snapshots du système de fichiers correctement intégrées à PostgreSQL. Dans cet article, nous utiliserons une approche native basée sur pg_basebackup et l'archivage WAL, car il permet de comprendre clairement comment le mécanisme fonctionne réellement.
Composants requis
Pour faire fonctionner un PITR, vous avez besoin de quatre éléments :
1. Une sauvegarde de base valide , effectuée avant la date à laquelle nous souhaitons revenir.
2. Archivage continu des journaux WAL , configuré avant l'incident. Si les journaux WAL n'ont pas été sauvegardés, les modifications postérieures à la sauvegarde ne pourront pas être reconstituées.
3. Une commande de restauration WAL, c'est-à-dire le paramètre restore_command, qui indique à PostgreSQL où récupérer les segments archivés lors de la récupération.
4. Un objectif de rétablissement, par exemple recovery_target_time, qui définit le point exact auquel arrêter la rediffusion.
Il est important de le rappeler : la reprise après sinistre ne peut être improvisée. Elle doit être conçue à l’avance, testée régulièrement et intégrée à une stratégie de sauvegarde cohérente. Disposer d’une sauvegarde sans journaux WAL archivés signifie qu’il est impossible de revenir en arrière sans tenir compte de la date de la sauvegarde. Disposer d’un journal WAL sans base de sauvegarde valide signifie qu’il n’existe aucun point de départ fiable.
Activer l'archivage WAL
La première étape consiste à configurer PostgreSQL pour qu'il copie chaque segment WAL terminé dans un répertoire d'archivage sécurisé. En production, ce répertoire devrait se trouver sur un support de stockage distinct, de préférence distant ou répliqué. Dans cet exemple, nous utiliserons un répertoire local.
sudo mkdir -p /backup/postgresql/wal_archive
sudo chown postgres:postgres /backup/postgresql/wal_archive
sudo chmod 700 /backup/postgresql/wal_archive
Dans le fichier postgresql.conf Commençons par configurer les paramètres essentiels :
wal_level = replica
archive_mode = on
archive_command = 'test ! -f /backup/postgresql/wal_archive/%f && cp %p /backup/postgresql/wal_archive/%f'
archive_timeout = 300
max_wal_senders = 10
Le paramètre archive_mode = on Active l'archivage WAL. Le paramètre archive_command Elle est exécutée par PostgreSQL lorsqu'un segment WAL est prêt à être archivé. Les variables %p e %f représentent respectivement le chemin d'accès au fichier WAL d'origine et le nom du fichier à enregistrer dans l'archive.
La commande d'exemple utilise test ! -f Pour éviter d'écraser un fichier existant, il est important de noter qu'un système de stockage WAL doit être prudent. En cas d'échec de la commande, PostgreSQL continuera de réessayer afin d'éviter la perte du segment. En production, vous pouvez utiliser des commandes plus sophistiquées, telles que rsync, scp, rclone, l'interface de ligne de commande AWS (aws cli) ou des outils dédiés comme pgBackRest et Barman.
Après la modification, vous devez redémarrer PostgreSQL, car archive_mode nécessite un redémarrage :
sudo systemctl restart postgresql
Vous pouvez forcer une commutation WAL et vérifier que le stockage fonctionne :
SELECT pg_switch_wal();
ls -lh /backup/postgresql/wal_archive/
Si des fichiers portant des noms similaires apparaissent dans le répertoire 00000001000000000000000ALe stockage fonctionne.
Créer un utilisateur pour pg_basebackup
pg_basebackup Il se connecte à PostgreSQL via le protocole de réplication. Par conséquent, il est recommandé de créer un utilisateur dédié disposant des privilèges nécessaires. REPLICATION:
CREATE ROLE backup_user WITH LOGIN REPLICATION PASSWORD 'PASSWORD_FORTE';
Dans le fichier pg_hba.conf Les connexions de réplication doivent être autorisées, en adaptant les adresses et les politiques de sécurité à votre environnement :
host replication backup_user 127.0.0.1/32 scram-sha-256
Après la modification :
sudo systemctl reload postgresql
Effectuez une sauvegarde physique de base
Nous pouvons maintenant effectuer une sauvegarde de base. Supposons que nous voulions enregistrer la sauvegarde dans /backup/postgresql/base_2026-06-10:
sudo mkdir -p /backup/postgresql/base_2026-06-10
sudo chown postgres:postgres /backup/postgresql/base_2026-06-10

sudo -u postgres pg_basebackup \
  -h 127.0.0.1 \
  -U backup_user \
  -D /backup/postgresql/base_2026-06-10 \
  -Fp \
  -Xs \
  -P
l'option -D indique le répertoire de destination. -Fp produit une sauvegarde au format brut, c'est-à-dire une copie physique du répertoire de données. -Xs inclut la diffusion en continu des WAL nécessaires pendant la sauvegarde. -P indique l'avancement de l'opération.
Cette sauvegarde n'est pas une copie SQL : il s'agit d'une copie physique du cluster PostgreSQL. Elle comprend les bases de données, les catalogues système, les index, les tables, les configurations du répertoire de données et les fichiers nécessaires au redémarrage. C'est pourquoi la restauration s'effectue au niveau du cluster et non au niveau de chaque base de données.
Exemple de scénario : suppression accidentelle
Imaginons ce scénario. À 2 h du matin, une sauvegarde de base est effectuée. Durant la matinée, la base de données fonctionne normalement et les journaux WAL sont archivés. À 14 h 36 min 12 s, un opérateur exécute accidentellement une requête malveillante :
DELETE FROM ordini;
L'objectif est de restaurer PostgreSQL à son état immédiatement précédent, par exemple à 2026-06-10 14:36:00+02Si nous disposons de la sauvegarde de base à 02h00 du matin et de tous les WAL générés jusqu'à cette heure, nous pouvons effectuer une restauration à l'intérieur des répertoires (PITR).
La procédure la plus sûre consiste à effectuer la restauration sur un serveur distinct, à valider les données récupérées, puis à décider s'il convient de remplacer le serveur principal, d'exporter les tables corrigées ou de mettre en œuvre une stratégie de restauration à l'état antérieur. Il est possible d'effectuer une restauration à l'état antérieur directement sur le serveur de production, mais cela accroît le risque opérationnel en l'absence d'un plan précis.
procédure de restauration PITR
Commencez par arrêter PostgreSQL sur le serveur de restauration ou le serveur concerné :
sudo systemctl stop postgresql
Le chemin d'accès au répertoire de données varie selon la distribution. Sur les systèmes Debian et Ubuntu, il est souvent similaire à : /var/lib/postgresql/16/main; sur les systèmes RHEL, AlmaLinux et Rocky Linux, il est souvent similaire à /var/lib/pgsql/16/dataDans cet exemple, nous utiliserons une variable pour rendre les commandes plus lisibles :
export PGDATA=/var/lib/pgsql/16/data
Sécurisons le répertoire de données actuel :
sudo mv $PGDATA ${PGDATA}.broken.$(date +%F-%H%M%S)
sudo mkdir -p $PGDATA
sudo chown postgres:postgres $PGDATA
sudo chmod 700 $PGDATA
Restaurons la sauvegarde de base :
sudo -u postgres rsync -aH --numeric-ids \
  /backup/postgresql/base_2026-06-10/ \
  $PGDATA/
Il faut maintenant indiquer à PostgreSQL de démarrer en mode de récupération. Cette méthode n'est plus utilisée dans la version 12 et les versions ultérieures. recovery.conf; à la place, un fichier vide appelé recovery.signal dans le répertoire de données et configurez les paramètres de récupération dans postgresql.conf o postgresql.auto.conf.
sudo -u postgres touch $PGDATA/recovery.signal
Ajoutons ou modifions ces paramètres :
restore_command = 'cp /backup/postgresql/wal_archive/%f %p'
recovery_target_time = '2026-06-10 14:36:00+02'
recovery_target_inclusive = false
recovery_target_action = 'pause'
restore_command indique comment récupérer chaque WAL archivé. recovery_target_time C’est le moment que nous voulons atteindre. recovery_target_inclusive = false demande à PostgreSQL de s'arrêter avant la cible, le cas échéant. recovery_target_action = 'pause' Il s'agit d'un choix judicieux : lorsque l'objectif est atteint, PostgreSQL s'arrête en mode récupération et vous permet d'inspecter les données avant la promotion finale.
Commençons le service :
sudo systemctl start postgresql
Au démarrage, PostgreSQL lira la sauvegarde et utilisera le backup_label pour localiser le point de départ de la rediffusion, il appellera le restore_command pour récupérer les WAL archivés et appliquer les modifications jusqu'à la date cible spécifiée.
Vérifier le résultat
Si nous avons choisi recovery_target_action = 'pause'La base de données peut être en lecture seule pendant la phase de récupération. Vous pouvez vérifier son état avec :
SELECT pg_is_in_recovery();
Nous pouvons ensuite vérifier si les données sont revenues à l'état souhaité :
SELECT count(*) FROM ordini;
SELECT max(updated_at) FROM ordini;
Si le contenu est correct, nous pouvons achever la récupération et promouvoir l'instance :
SELECT pg_wal_replay_resume();
Sinon, si vous préférez promouvoir automatiquement votre serveur lorsque l'objectif est atteint, vous pouvez utiliser :
recovery_target_action = 'promote'
Dans les environnements critiques, cependant, la pause est souvent préférable car elle permet une vérification manuelle avant de rendre le cluster récupéré accessible en écriture.
Points de restauration nommés
PostgreSQL permet également de créer des points de restauration nommés. Cette fonctionnalité est très utile avant des opérations risquées, telles que les mises à jour d'applications, les migrations massives, les déploiements complexes ou les manipulations manuelles de données.
SELECT pg_create_restore_point('prima_migrazione_ordini');
Durant la phase de récupération, vous pouvez ensuite utiliser :
restore_command = 'cp /backup/postgresql/wal_archive/%f %p'
recovery_target_name = 'prima_migrazione_ordini'
recovery_target_action = 'pause'
Cette approche est plus élégante que le simple recours à un horodatage lorsque le point critique est connu à l'avance. Le point de restauration étant enregistré dans les journaux WAL, il est toujours nécessaire que l'archivage WAL soit correctement actif.
Attentions opérationnelles
La fonction PITR de PostgreSQL est puissante, mais elle exige de la rigueur. La première règle est de tester périodiquement la restauration. Une sauvegarde non testée n'est qu'un espoir. Il est indispensable de vérifier que les sauvegardes de base sont lisibles, que les journaux WAL sont complets et que… restore_command des fonctions et que les temps de récupération soient compatibles avec les objectifs commerciaux.
La deuxième règle consiste à protéger l'archive WAL. Si les WAL sont stockés sur le même disque que la base de données, une panne de stockage peut compromettre les données principales et rendre impossible leur récupération. En production, il est préférable de les stocker sur un support de stockage distant, un référentiel dédié, un stockage objet ou un serveur de sauvegarde distinct.
La troisième règle consiste à gérer correctement les chronologies. Après une restauration à point de récupération (PITR) et une promotion, PostgreSQL crée une nouvelle chronologie. Cela signifie que l'historique du cluster se divise : à partir de ce point, une nouvelle séquence WAL est créée, dérivée du point de récupération. Ce comportement est normal, mais il est essentiel de le comprendre pour la gestion des réplicas, des restaurations supplémentaires ou des archives WAL partagées.
La quatrième règle consiste à supprimer ou à commenter les paramètres de récupération après la restauration, lorsqu'ils ne sont plus nécessaires. À partir de la version 12, le fichier recovery.signal La gestion est assurée par le processus de récupération, mais les paramètres définis dans les fichiers de configuration peuvent être conservés. Les laisser actifs ou les oublier peut engendrer des confusions lors des opérations de réplication ou de restauration ultérieures.
Outils avancés : pgBackRest et Barman
La procédure décrite dans cet article utilise des outils natifs pour illustrer le fonctionnement de la restauration à un point précis dans le temps (PITR) en situation réelle. En production, il est toutefois souvent conseillé d'utiliser des outils spécialisés. pgBackRest et Barman permettent de gérer les restaurations complètes, différentielles, incrémentales, la rétention, la compression, la vérification, l'archivage WAL, les référentiels distants et les restaurations à un point précis dans le temps avec un niveau d'automatisation bien supérieur.
Ces outils ne modifient pas le principe de base : la restauration à la demande (PITR) repose toujours sur les sauvegardes et la relecture des journaux WAL. Cependant, ils rendent les opérations quotidiennes plus robustes et reproductibles, réduisant ainsi le risque d’erreur humaine. Pour les entreprises qui gèrent PostgreSQL en production, sur des plateformes e-commerce, de gestion, CRM ou critiques, une solution structurée est presque toujours préférable à des scripts manuels non supervisés.
conclusion
La restauration à un point précis dans le temps est une fonctionnalité essentielle de PostgreSQL pour garantir la continuité des activités et une protection optimale des données. Contrairement à une simple sauvegarde logique, elle permet de reconstruire l'intégralité du cluster à un état antérieur, en s'appuyant sur une base de sauvegarde physique et un archivage WAL continu.
La procédure peut se résumer en quelques étapes : activer l’archivage WAL, effectuer des sauvegardes régulières et cohérentes, stocker les fichiers WAL en toute sécurité, restaurer la sauvegarde en cas de besoin, créer recovery.signal, configurez restore_command et définissez la cible de récupération souhaitée. À partir de ce moment, PostgreSQL relit son historique des transactions et s'arrête au point défini.
La valeur du PITR ne se mesure pas seulement au moment d'un sinistre, mais aussi lors de sa préparation. Sans journaux WAL archivés, sans tests de restauration et sans procédures documentées, le PITR reste théorique. Correctement mis en œuvre, il devient cependant l'un des outils les plus efficaces pour réduire les pertes de données et traiter méthodiquement les suppressions accidentelles, les bogues applicatifs, les migrations incorrectes et les incidents opérationnels.
Pour les administrateurs de PostgreSQL en production, le message est clair : il ne suffit pas de se demander si une sauvegarde existe. Il faut se demander jusqu’à quelle période on peut remonter, sur quelle période et avec quel niveau de certitude. La restauration à la demande (PITR) répond précisément à ce besoin : elle transforme la sauvegarde, d’une simple copie passive, en une véritable stratégie de restauration contrôlée.

