
Table des matières de l'article :
Tout a commencé par un simple billet en apparence.
Un client nous a signalé que le téléchargement de certaines archives volumineuses depuis leur site était inexplicablement lent lorsqu'il était effectué via un navigateur.
Il ne s'agissait pas d'une différence marginale, facilement attribuable à la variabilité normale du réseau.
La même archive statique, d'environ 144 Mo, a été téléchargée depuis l'application cliente de bureau en environ 17 secondes, tandis que Chrome pouvait prendre plus de 90 secondes.
D'une part, nous avions un débit de l'ordre de 8 à 9 Mo/s.
En revanche, seulement 1,5 à 2 Mo/s.
Le serveur, comme beaucoup de nos clients, était hébergé chez Hetzner, en Allemagne, et utilisait NGINX avec HTTP/2 et HTTP/3 activés.
Face à une telle différence, le premier réflexe est presque inévitablement de se tourner vers internet.
MTU ?
Découverte du MTU du chemin ?
Perte de paquets ?
Pare-feu?
Filtrage UDP ?
Routage ?
Un problème d'infrastructure de centre de données ?
Une forme de limitation de débit ?
Un bug du navigateur ?
Toutes ces hypothèses sont absolument plausibles.
Le détail qui rendait l'affaire particulièrement intéressante était cependant un autre : l'application de bureau du client utilisait HTTP/1.1 sur TCP, tandis que Chrome, trouvant HTTP/3 annoncé par le serveur, utilisait QUIC sur UDP.
La question est alors devenue beaucoup plus précise :
Est-ce vraiment le protocole HTTP/3 qui a ralenti le transfert d'un facteur dix ?
Pour répondre à cette question, nous avons dû cesser de comparer différentes applications et isoler une seule variable.
Heureusement, le client avait déjà fait exactement cela.
Le client avait déjà isolé HTTP/2 de HTTP/3
La comparaison initiale entre l'application de bureau et Chrome était intéressante, mais pas encore suffisante pour établir un diagnostic.
Comparer deux applications différentes revient en réalité à introduire de nombreuses variables.
Votre application Node.js peut utiliser des tampons, des bibliothèques TLS, des stratégies de gestion de connexion et même des mécanismes de téléchargement différents de ceux de Chrome.
Le test véritablement pertinent consistait à utiliser :
- le même client ;
- le même ordinateur ;
- la même connexion Internet ;
- le même binaire que Chrome ;
- le même nom d'hôte ;
- le même serveur ;
- le même fichier ;
- le même point de terminaison HTTPS.
Seul le protocole devait changer.
Dans les exemples de cet article, afin de garantir la confidentialité de nos clients, nous anonymiserons le domaine d'origine en utilisant :
example.com
et nous appellerons le fichier :
example-package-0.2.3-win-x64.zip
L'URL utilisée pour les tests de performance devient alors :
https://example.com/downloads/example-package-0.2.3-win-x64.zip
L'important, c'est qu'il s'agissait d'un fichier totalement statique servi directement par NGINX.
Pas de PHP.
Pas de PHP-FPM.
Pas de WordPress.
Aucune base de données.
Pas de proxy vers un serveur dorsal.
Aucun code d'application.
Cette fonctionnalité allait devenir fondamentale car elle nous permettait d'exclure immédiatement un grand nombre de goulots d'étranglement potentiels.
Premier test : désactiver QUIC et utiliser HTTP/2
Chrome et Chromium vous permettent de les lancer avec QUIC complètement désactivé.
L'interrupteur est :
--disable-quic
Sous Windows, par exemple :
"C:\Program Files\Google\Chrome\Application\chrome.exe" ^
--disable-quic ^
--user-data-dir="%TEMP%\chrome-h2-test" ^
"https://example.com/downloads/example-package-0.2.3-win-x64.zip"
L'utilisation de :
--user-data-dir
C'est particulièrement utile lors de ce type d'évaluation comparative.
Chrome a tendance à réutiliser les processus et profils déjà ouverts. Le lancement d'un profil temporaire différent réduit les interférences provenant des sessions précédentes, du cache, de l'état des services alternatifs et des connexions existantes.
Sous Linux, l'équivalent pourrait être :
google-chrome
--disable-quic
--user-data-dir=/tmp/chrome-h2-test
"https://example.com/downloads/example-package-0.2.3-win-x64.zip"
Avec QUIC désactivé, Chrome a négocié HTTP/2.
Les résultats mesurés par le client étaient les suivants :
HTTP/2

7,65 MB/s
9,67 MB/s
Par conséquent, sensiblement conforme à la vitesse observée par le client HTTP/1.1, qui a saturé la bande passante de la connexion ADSL du consommateur (par exemple, lorsque nous travaillons à domicile, nous utilisons une connexion Fastweb de 100 mégabits).
Jusqu'ici, tout va bien.
Deuxième test : forcer le protocole HTTP/3 sur Chrome lui-même
À ce stade, l'instance précédente a été fermée et le même binaire Chrome a été relancé, forçant cette fois QUIC à utiliser l'origine spécifique.
L'interrupteur utilisé est :
--origin-to-force-quic-on=example.com:443
Il est important de prêter attention à la syntaxe.
Ce paramètre est parfois représenté de manière informelle dans la documentation ou les exemples comme suit :
--origin-to-force-quic-on=[example.com:443]
mais les crochets indiquent normalement un espace réservé et ne doivent pas être transmis littéralement.
La syntaxe exacte est :
--origin-to-force-quic-on=example.com:443
Pour rendre le test encore plus explicite, nous pouvons également utiliser :
--enable-quic
obtention:
"C:\Program Files\Google\Chrome\Application\chrome.exe" ^
--enable-quic ^
--origin-to-force-quic-on=example.com:443 ^
--user-data-dir="%TEMP%\chrome-h3-test" ^
"https://example.com/downloads/example-package-0.2.3-win-x64.zip"
Sous Linux :
google-chrome
--enable-quic
--origin-to-force-quic-on=example.com:443
--user-data-dir=/tmp/chrome-h3-test
"https://example.com/downloads/example-package-0.2.3-win-x64.zip"
Même ordinateur.
Même Chrome.
Même serveur.
Même fichier.
Même connexion.
Cette fois-ci, cependant, les résultats furent très différents et bien pires :
HTTP/3

1,64 MB/s
1,95 MB/s
Une différence énorme, passant de 10 mégaoctets par seconde (qui auraient certainement augmenté avec une connexion ADSL ou fibre plus rapide) à une connexion bridée à moins de 2 mégaoctets par seconde.
Le test décisif : H2 → H3 → H2
Le client avait également fait autre chose qui, sur le plan méthodologique, était tout à fait correct.
Les tests n'ont pas été exécutés en deux blocs distincts, par exemple dix benchmarks HTTP/2 le matin et dix benchmarks HTTP/3 une demi-heure plus tard.
Leurs destins étaient intimement liés.
La séquence était :
HTTP/2
HTTP/3
HTTP/2
Les résultats:
--disable-quic

HTTP/2
7,65 MB/s
9,67 MB/s
puis:
--enable-quic
--origin-to-force-quic-on=example.com:443

HTTP/3
1,64 MB/s
1,95 MB/s
et immédiatement après :
--disable-quic

HTTP/2
7,55 MB/s
9,68 MB/s
Sous une forme encore plus évidente :
HTTP/2    ~8-10 MB/s

HTTP/3    ~1,5-2 MB/s

HTTP/2    ~8-10 MB/s
Cette séquence commençait à rendre moins crédible l'explication fondée sur une congestion Internet générique.
Il faudrait en effet supposer que la connexion est soudainement devenue cinq ou six fois plus lente au moment précis où QUIC a été activé, puis est redevenue immédiatement plus rapide lors du retour à HTTP/2.
Possible en théorie.
Très improbable lorsque le résultat est reproductible.
Vérifiez le protocole dans les outils de développement de Chrome.
Lors de l'exécution de tests de performance de ce type, il est toutefois important de ne pas faire aveuglément confiance aux options utilisées pour lancer le navigateur.
Les outils de développement de Chrome vous permettent de visualiser le protocole réellement utilisé.
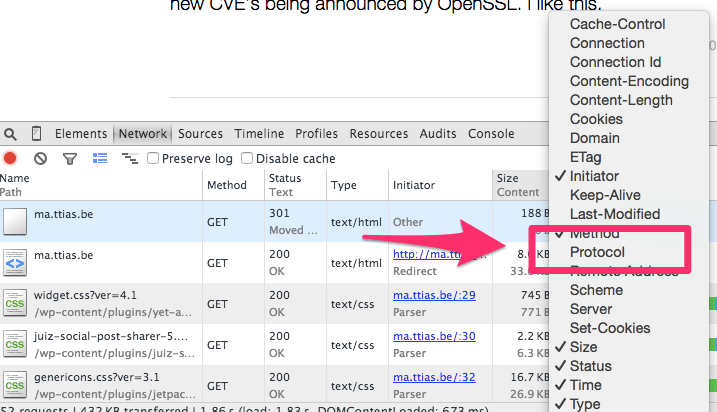
Je viens d'ouvrir :
F12
→ Network
et activer la colonne :
Protocol
Le premier test consiste à vérifier la présence de :
h2
tandis que dans le second :
h3
Ce contrôle empêche qu'une requête soit interprétée comme HTTP/3 si, pour une raison quelconque, elle est passée en HTTP/2.
Première hypothèse : un problème UDP sur le réseau Hetzner ?
HTTP/2 utilise TCP.
HTTP/3 utilise QUIC sur UDP.
Il était donc naturel de commencer par étudier tout ce qui pouvait pénaliser le protocole UDP tout en laissant le protocole TCP essentiellement inchangé.
Le serveur était hébergé sur l'infrastructure Hetzner en Allemagne, et nous avons commencé à envisager d'éventuels comportements spécifiques au chemin réseau.
Parmi les premières hypothèses :
- Perte de paquets UDP ;
- Filtrage UDP ;
- Police UDP;
- routage différent ;
- problèmes de pare-feu intermédiaires ;
- Un codage ou une mise en forme différents pour UDP et TCP.
Une faible perte de paquets peut avoir un impact significatif sur le contrôle de la congestion.
HTTP/3 n'est pas simplement « HTTP/2 sur UDP » : QUIC implémente directement de nombreuses fonctionnalités qui appartiennent traditionnellement à la pile TCP, notamment les accusés de réception, le contrôle de la congestion et les retransmissions.
Le comportement d'un flux QUIC en présence de pertes peut donc être significativement différent.
Deuxième hypothèse : découverte des MTU et des MTU de chemin
Nous avons ensuite examiné l'un des problèmes classiques des connexions UDP : l'unité de transmission maximale (MTU).
Un chemin avec une MTU plus petite que prévu, un tunnel intermédiaire ou une gestion incorrecte des messages ICMP Packet Too Big peuvent entraîner un comportement difficile à diagnostiquer.
TCP bénéficie depuis des décennies d'un écosystème très mature autour des MSS et des MTU de chemin.
QUIC doit donc gérer les datagrammes UDP et la mise en paquets en fonction de sa propre dynamique.
Ils sont alors devenus suspects :
MTU
PMTU
ICMP filtering
UDP fragmentation
tunnel
VLAN/VXLAN
Lors d'un tel diagnostic, il peut être utile d'observer directement le trafic :
tcpdump -ni any udp port 443
et comparez-le avec :
tcpdump -ni any tcp port 443
Mais il manquait quelque chose ici aussi.
Le débit HTTP/3 ne semblait pas seulement « saccadé ».
Cela semblait presque s'arrêter systématiquement autour d'une valeur précise.
Statistiques UDP du tampon de socket et du noyau
La recherche s'est ensuite poursuivie dans la pile Linux.
Un serveur HTTP/3 performant dépend également d'une gestion correcte des sockets UDP.
Parmi les premiers contrôles :
netstat -su
ou:
nstat -az
à la recherche de valeurs telles que :
UdpInErrors
UdpRcvbufErrors
UdpSndbufErrors
puis les tampons du noyau :
sysctl net.core.rmem_max
sysctl net.core.wmem_max
sysctl net.core.rmem_default
sysctl net.core.wmem_default
Toutes les hypothèses techniquement valides.
Mais ce chiffre est resté le même.
Environ 1,6 Mo/s.
Le chiffre qui commençait à paraître trop précis : 64 Ko
Au cours de l'analyse, nous avons commencé à examiner de plus près la configuration HTTP/3 de NGINX.
Il existe une directive appelée :
http3_stream_buffer_size
La documentation officielle le décrit comme la taille du tampon utilisé pour lire et écrire les flux QUIC.
La valeur par défaut est :
http3_stream_buffer_size 64k;
et la directive peut être définie dans les contextes :
http
server
La valeur de 64 Ko est immédiatement devenue intéressante.
Un responsable de la maintenance de NGINX nous a expliqué que NGINX limite la quantité d'octets non acquittés sur un seul flux HTTP/3 en fonction de http3_stream_buffer_size.
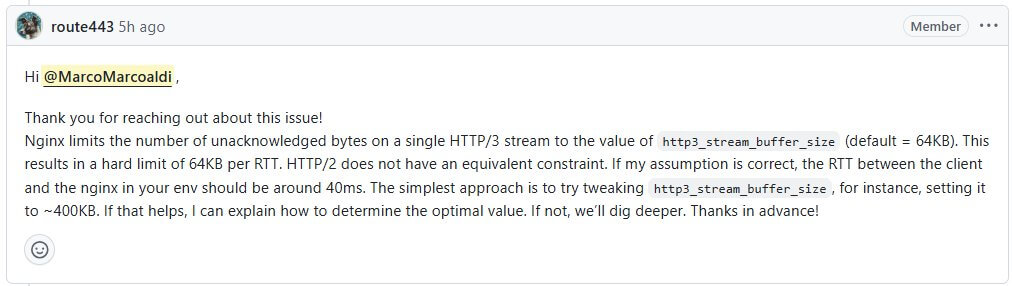
Concrètement, cela peut se traduire, sous certaines conditions, par une limite de l'ordre de :
buffer / RTT
Imaginons un RTT d'environ :
40 ms
Avec le tampon par défaut :
64 KB
nous obtenons :
64 KB / 0,040 s ≈ 1,6 MB/s
Et c'était exactement du même ordre de grandeur que nos valeurs de référence :
1,64 MB/s
1,95 MB/s
À ce moment-là, le problème a cessé de paraître aléatoire.
Le concept de produit bande passante-délai
Le principe est le même que celui que connaissent ceux qui travaillent avec TCP depuis des années, à propos du produit bande passante-délai.
Si nous voulons maintenir une certaine quantité de bande passante constamment occupée, nous devons avoir suffisamment de données « en transit » pendant le temps nécessaire pour que les accusés de réception reviennent à l'expéditeur.
Supposons que nous voulions atteindre l'objectif suivant :
10 MB/s
avec:
RTT = 40 ms
Le BDP est :
10 MB/s × 0,040 s
à savoir:
0,4 MB
à propos de:
400 KB
Un tampon de 64 Ko est donc beaucoup plus petit que la quantité de données qui devraient pouvoir rester en transit simultanément pour saturer ce chemin.
Ce n'est pas un hasard si la suggestion reçue était d'essayer une valeur de l'ordre de :
http3_stream_buffer_size 400k;
ou, plus commodément :
http3_stream_buffer_size 512k;
Pour avoir une marge, nous pourrions utiliser :
http3_stream_buffer_size 1m;
L'importance du BDP dans le dimensionnement des fenêtres et des tampons sur les chemins à large bande passante et à latence élevée n'est pas nouvelle : c'est l'un des principes fondamentaux du débit des réseaux étendus.
On notait également un détail curieux dans la documentation technique publiée par NGINX lui-même : dans ses tests de performance QUIC avec un RTT et un BDP élevés, NGINX utilisait :
http3_stream_buffer_size 50m;
donc une valeur considérablement supérieure à la valeur par défaut de 64 Ko.
Un problème déjà constaté par d'autres
Entre-temps, nous avons également trouvé un problème public NGINX extrêmement similaire, #1498 (https://github.com/nginx/nginx/issues/1498), un problème relativement récent et actuel étant donné que nous sommes le 1er septembre 2026 et que le problème a été ouvert le 23 juin 2026, il y a environ 2 mois.
Dans ce cas, un fichier statique de 1 Go était servi directement par NGINX.
Les résultats étaient approximativement les suivants :
HTTP/2    ~30 MB/s
HTTP/3    ~3,2 MB/s
Même serveur, même chemin réseau, aucune application en amont.
Les protocoles UDP et GSO, ainsi que d'autres aspects du réseau, ont également été vérifiés, mais aucune explication immédiate n'a été trouvée. Le problème est actuellement analysé par le projet NGINX.
Le parallèle avec notre cas était évident.
Notre relation portait sur :
9 MB/s vs 1,8 MB/s
celui du problème :
30 MB/s vs 3,2 MB/s
Il ne s'agissait pas forcément du même bug, mais certainement du même type de phénomène.
Modifichiamo http3_stream_buffer_size
À ce moment-là, il nous semblait avoir trouvé la bonne voie.
La configuration principale de l'hôte virtuel contenait, sous forme simplifiée :
server {
listen 192.0.2.10:443 quic reuseport;
listen 192.0.2.10:443 ssl http2;

```
server_name example.com;

...

quic_gso on;
http3_stream_buffer_size 16m;

...
```

}
Nous avions intentionnellement utilisé :
16m
une valeur considérablement supérieure aux 400 à 500 Ko théoriquement requis.
Non pas parce que 16 Mo était la valeur idéale à utiliser en production, mais parce que nous souhaitions un test quasi binaire.
Si le problème venait du tampon, en passant de :
64 KB
a:
16 MB
Le changement aurait dû être évident.
Nous avons réalisé :
nginx -t
suivi du rechargement.
Nouvelle référence.
Le protocole HTTP/3 a continué de fonctionner à peu près à la même vitesse.
Environ dix fois plus lent que HTTP/2.
Il semblait que l'hypothèse était fausse.
Et pourtant, c'est précisément à ce moment-là que l'affaire est devenue plus intéressante.
Pourquoi 16m Rien n'a changé ?
La configuration contenait deux hôtes virtuels HTTPS sur la même paire IP:port.
Sous une forme extrêmement simplifiée :
server {
listen 192.0.2.10:443 quic;
listen 192.0.2.10:443 ssl http2;

```
server_name www.example.com;

...
```

}
et par la suite :
server {
listen 192.0.2.10:443 quic reuseport;
listen 192.0.2.10:443 ssl http2;

```
server_name example.com;

http3_stream_buffer_size 16m;

...
```

}
La directive :
http3_stream_buffer_size 16m;
était présent exclusivement dans le second server {}.
Normalement, lorsqu'on pense en termes de protocole HTTP traditionnel et d'hébergement virtuel, on pense naturellement à :
La demande concerne
example.com, puis NGINX sélectionne le bloc serveur deexample.comet utilise ses paramètres.
Mais QUIC introduit un problème de synchronisation.
La connexion doit être initialisée avant qu'une requête HTTP normale et entièrement traitée puisse exister.
C’est à ce moment-là que nous avons décidé de ne plus nous contenter de penser à la documentation et de passer directement à la lecture du code source de NGINX.
Lecture du code source de NGINX : là où la connexion HTTP/3 commence réellement
La caractéristique intéressante se trouve dans :
src/http/ngx_http_request.c
à l'intérieur:
ngx_http_init_connection()
Il s'agit d'une fonctionnalité très importante car elle représente l'un des premiers points où NGINX associe une nouvelle connexion au sous-système HTTP.
Le code détermine d'abord l'adresse et la configuration du port sur lesquelles la connexion est arrivée.
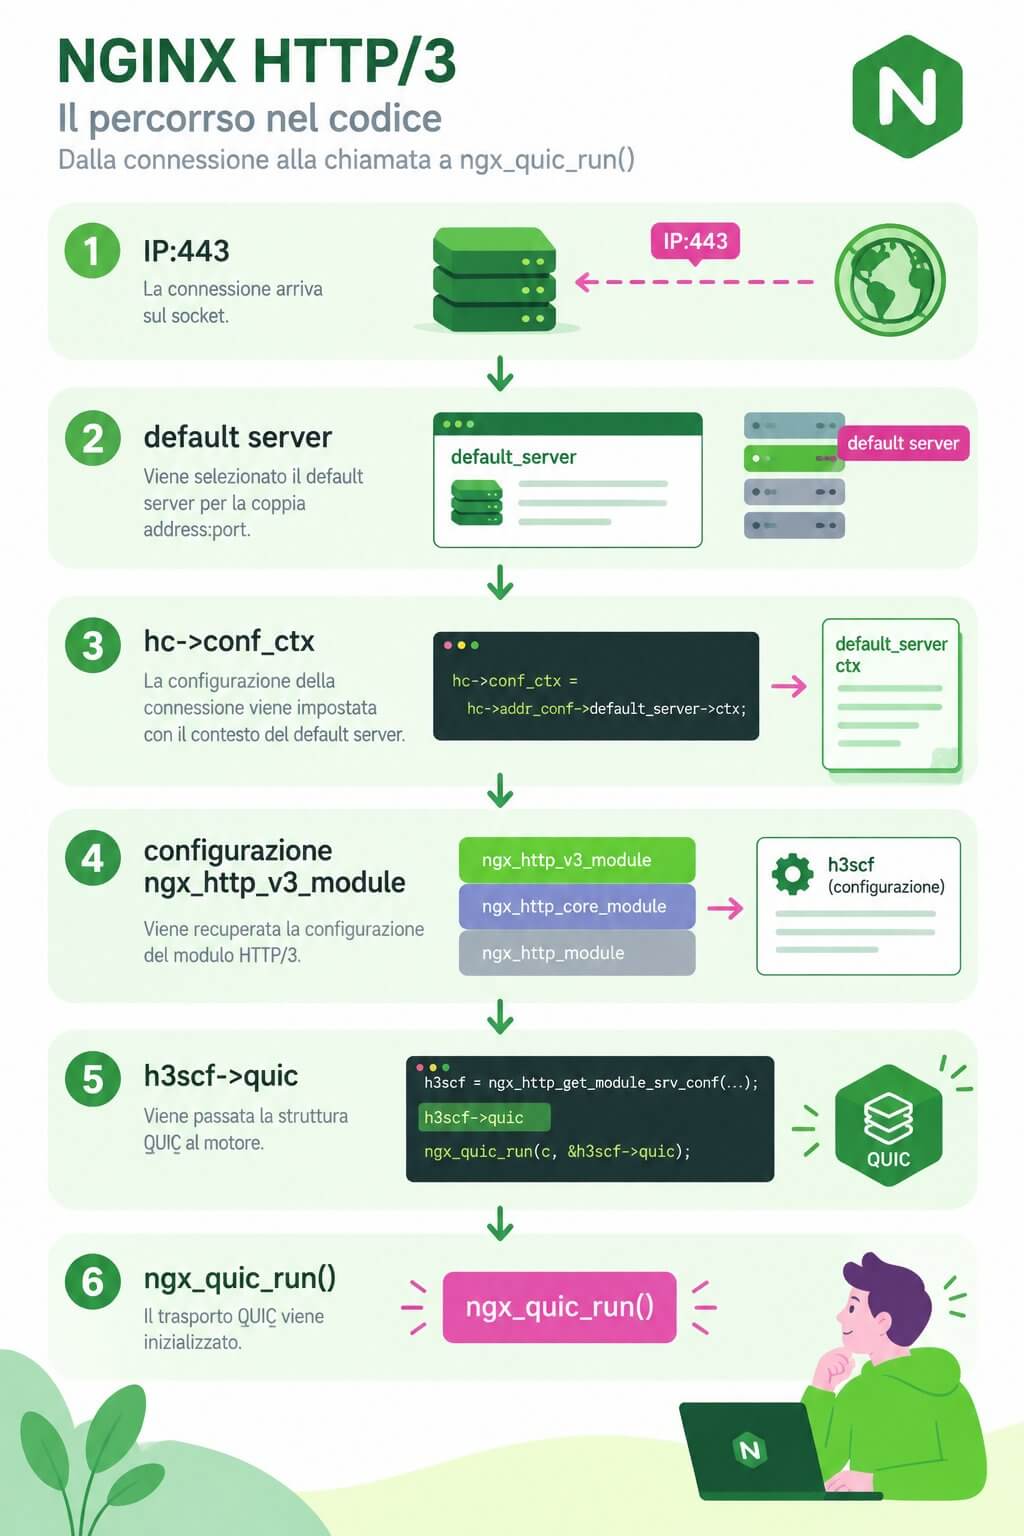
À un moment donné, nous trouvons une ligne particulièrement significative :
hc->conf_ctx = hc->addr_conf->default_server->ctx;
Le commentaire qui précède immédiatement le code source de NGINX est tout aussi explicite : la configuration serveur par défaut pour cette paire adresse:port est utilisée à ce stade.
Cela signifie qu'à ce moment précis, NGINX n'a pas encore démarré à partir de la configuration d'hôte virtuel que l'on associe intuitivement au nom demandé.
Il travaille dans le contexte de :
default_server
associé à l'auditeur.
Pour l'instant, cela ne semble pas poser de problème.
La partie cruciale arrive quelques instructions plus tard.
Dans cette même fonction, on trouve la gestion spécifique HTTP/3 :
if (hc->addr_conf->quic) {
ngx_http_v3_init_stream(c);
return;
}
La séquence logique devient alors :
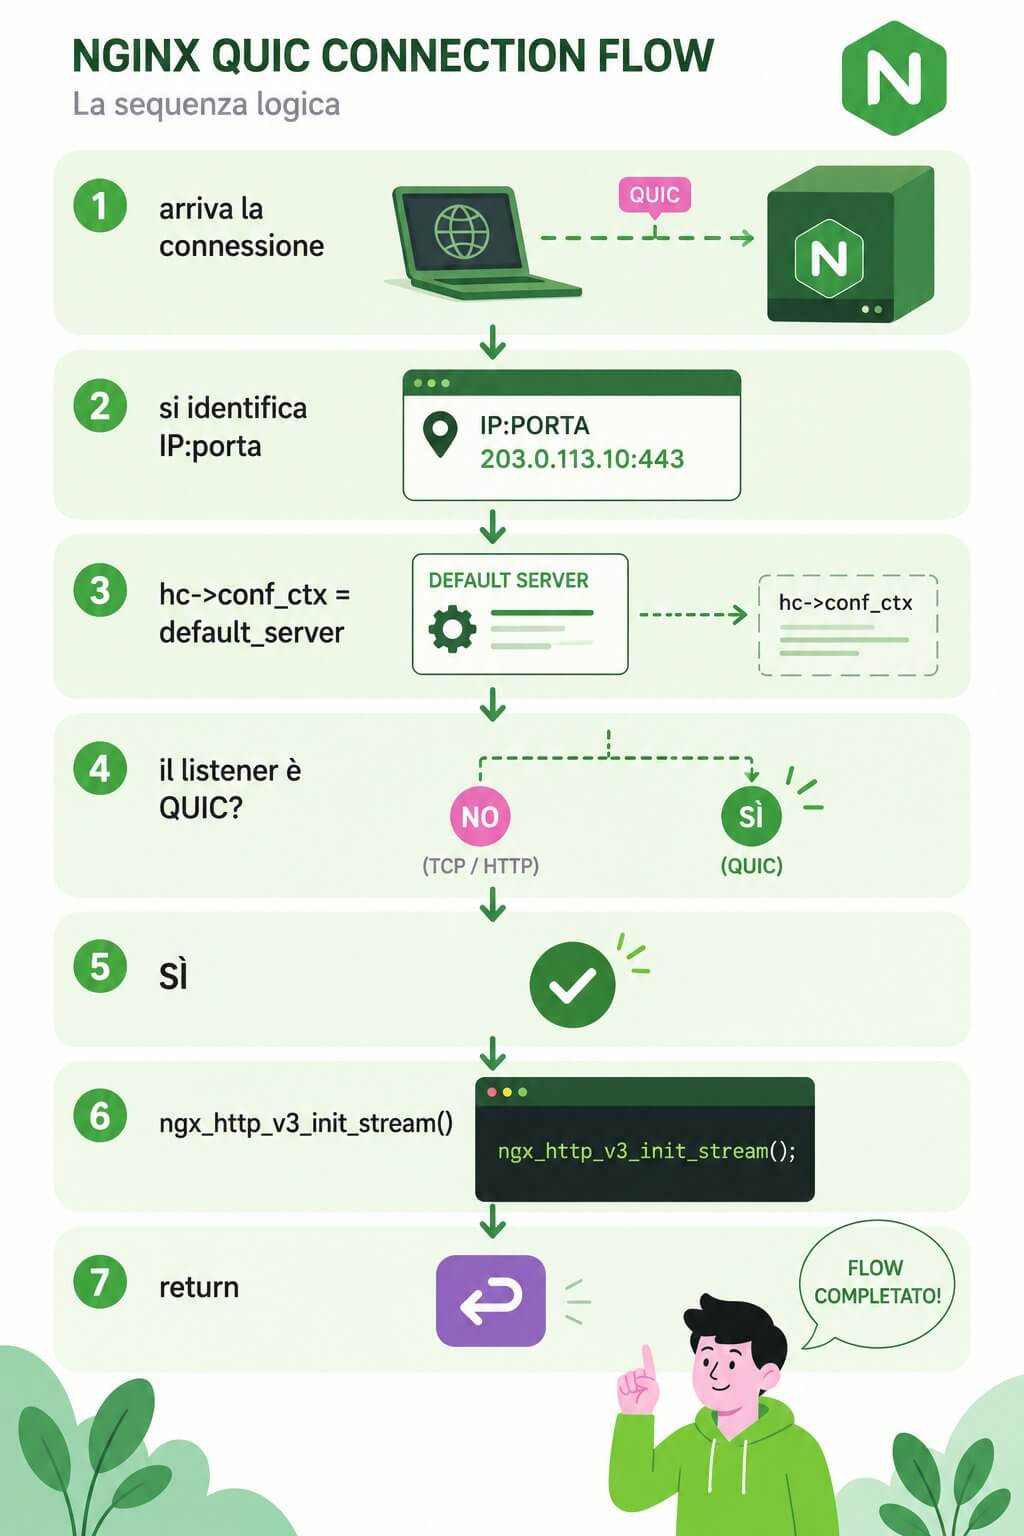
Cet return est particulièrement important.
NGINX ne suit pas le processus normal d'attente et d'analyse de la requête HTTP.
Si la connexion est de type QUIC, elle entre immédiatement dans l'initialisation HTTP/3.
Entrons. ngx_http_v3_init_stream()
À ce stade, nous avons suivi le flux du fichier :
src/http/v3/ngx_http_v3_request.c
La fonction :
ngx_http_v3_init_stream()
reçoit la connexion nouvellement initialisée.
À l'intérieur, on trouve un autre passage décisif :
h3scf = ngx_http_get_module_srv_conf(hc->conf_ctx,
ngx_http_v3_module);
et peu après :
ngx_quic_run(c, &h3scf->quic);
Essayons de le traduire sans nous perdre dans les détails de l'API interne de NGINX.
h3scf Voici la configuration serveur du module HTTP/3.
D'où provient-il ?
Par:
hc->conf_ctx
Mais quelques instants avant cela hc->conf_ctx avait été configuré pour :
default_server->ctx
Le chemin devient donc :
C’est à ce moment-là que notre configuration a enfin commencé à avoir du sens.
Le paramètre :
http3_stream_buffer_size 16m;
était présent dans le deuxième hôte virtuel.
Mais la connexion QUIC a été initialisée en utilisant le contexte disponible avant la sélection normale de l'hôte virtuel HTTP basée sur la requête.
La source montre également que, lors de la création ultérieure de flux QUIC enfants, NGINX peut hériter du contexte de connexion HTTP/3 parent après le traitement du nom du serveur ; mais à ce stade, le transport QUIC initial a déjà été démarré via ngx_quic_run().
Et c'était précisément le détail que nous recherchions.
Approfondissons encore : où est définie la valeur par défaut de 64 Ko ?
À ce stade, il manquait une dernière vérification.
Où se déroule réellement l'histoire :
65536
par défaut ?
La réponse se trouve dans :
src/http/v3/ngx_http_v3_module.c
La définition de la directive associe :
http3_stream_buffer_size
directement à :
quic.stream_buffer_size
dans la configuration HTTP/3.
Lors de la création de la configuration, la valeur est initialement marquée comme non définie.
Ensuite, dans la fonction de fusion de configuration, nous trouvons la valeur :
65536
comme valeur par défaut finale.
Survol :
65536 byte = 64 KiB
La source a ensuite confirmé exactement ce que la documentation rapportait :
http3_stream_buffer_size 64k;
Mais surtout, cela a montré que cette valeur se retrouvait directement intégrée à la structure :
quic.stream_buffer_size
qui a ensuite été remplacé par le moteur QUIC.
Nous avions finalement reconstitué l'intégralité du parcours.
En termes simples, le chemin complet dans le code NGINX est :
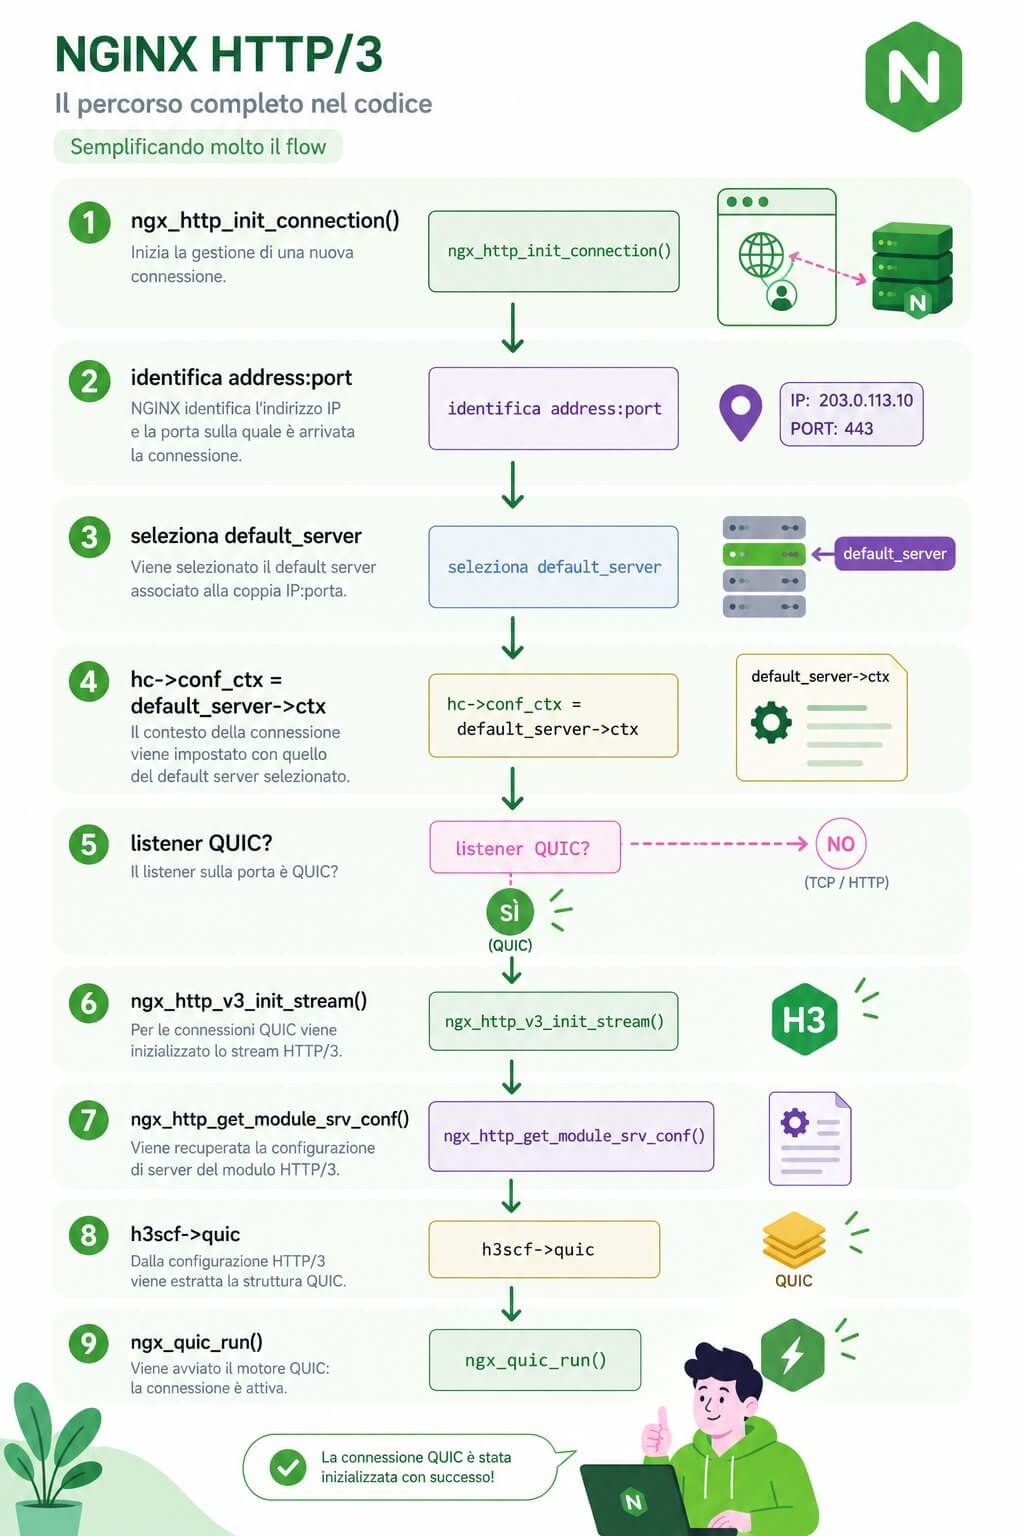
L'important n'est pas tant de connaître ces fonctions par cœur.
Il s'agit de comprendre l'ordre temporel des événements.
Avec HTTP/3, on ne peut pas toujours penser qu'une requête HTTP normale et complète arrive d'abord et que l'hôte virtuel entier est sélectionné seulement ensuite.
Certains paramètres nécessaires au transport QUIC doivent être disponibles beaucoup plus tôt.
La solution : déplacer le paramètre dans son contexte http
À ce stade, nous avons modifié la configuration.
Au lieu d'avoir :
server {
server_name example.com;

```
http3_stream_buffer_size 16m;
```

}
nous avons déplacé le paramètre dans le bloc global :
http {

```
http3_stream_buffer_size 1m;

...
```

}
La directive soutient officiellement les deux contextes :
http
server
Utilisez-le au niveau http {} Cependant, dans notre scénario, cela présentait un avantage clé : tous les serveurs virtuels héritaient de la même valeur, et il n’y avait plus aucune ambiguïté lors de l’initialisation QUIC associée à l’écouteur.
Nous avons vérifié la configuration chargée réelle avec :
nginx -T 2>&1 | grep -n http3_stream_buffer_size
donc:
nginx -t
e:
systemctl reload nginx
Nouvelle référence.
Cette fois, le résultat a changé immédiatement.
Le protocole HTTP/3 n'était plus bloqué aux alentours de 1,5-2 Mo/s.
Le débit était comparable à celui obtenu avec HTTP/2.
Le problème a été résolu.
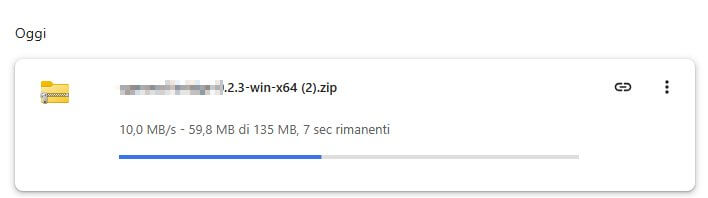
Même Chrome a réussi à saturer la connexion de notre forfait Fastweb de 100 mégabits.
Parce que la première modification semblait correcte, mais elle ne l'était pas.
C'est probablement la partie la plus intéressante de toute cette affaire.
La configuration :
server {
server_name example.com;

```
http3_stream_buffer_size 16m;
```

}
Ce n'était pas syntaxiquement incorrect.
NGINX l'a accepté.
nginx -t renvoyé correctement :
syntax is ok
test is successful
La directive est officiellement autorisée dans le contexte server.
Pourtant, dans la topologie particulière avec plusieurs hôtes virtuels QUIC sur le même socket, cela n'affectait pas la phase de la connexion qui nous intéressait.
Ce n'était donc pas une erreur de syntaxe.
Il s'agissait d'une incompréhension du cycle de vie de la connexion.
Et c'est précisément là que la lecture du code source peut faire la différence.
Ne définissez pas 16 Mo sans raison.
Dans notre test, nous avons utilisé :
http3_stream_buffer_size 16m;
uniquement à titre expérimental.
Cela ne signifie pas pour autant que 16 Mo est la valeur optimale.
Idéalement, ce paramètre devrait être dimensionné en fonction du produit bande passante-délai du type de connexions que nous souhaitons prendre en charge.
Avec:
10 MB/s
40 ms RTT
nous avons:
10 × 0,040 = 0,4 MB
donc environ 400 Ko.
Une valeur comme :
http3_stream_buffer_size 512k;
Cela pourrait déjà suffire.
Ou vous pouvez utiliser une marge :
http3_stream_buffer_size 1m;
Bien sûr, il n'existe pas de nombre universellement correct.
Prenons par exemple un serveur qui doit prendre en charge :
50 MB/s
envers le client avec :
80 ms RTT
Le BDP devient :
50 × 0,080 = 4 MB
Dans ce cas, une mémoire tampon de 512 Ko serait à nouveau insuffisante pour utiliser pleinement le chemin.
La valeur correcte dépend donc de :
throughput desiderato
×
RTT atteso
avec une marge opérationnelle appropriée.
Liste de contrôle diagnostique pratique
Si vous constatez que HTTP/3 est nettement plus lent que HTTP/2, je ne commencerais pas par modifier dix paramètres à la fois.
La séquence que ce cas nous a suggérée ressemble davantage à la suivante.
Commencez par isoler le protocole :
H2 → H3 → H2
Vérifiez ensuite que le fichier est bien statique.
Prochaine vérification du RTT :
ping example.com
et comparez-le au débit observé.
Si, par exemple, vous avez :
RTT ≈ 40 ms
HTTP/3 ≈ 1,5 MB/s
La valeur par défaut de 64 Ko devient immédiatement suspecte.
Vérifiez ensuite :
http3_stream_buffer_size
et surtout, l'endroit où il était configuré.
Avec plusieurs hôtes virtuels QUIC sur le même socket, vérifiez lequel est le serveur par défaut et envisagez sérieusement de définir les paramètres QUIC partagés dans leur contexte :
http {}
Je ne passerai aux autres hypothèses possibles que si le tampon ne modifie pas le comportement :
MTU / PMTU
UDP packet loss
firewall
UDP policing
routing
GSO
GRO
socket buffer
NIC
kernel
congestion control
Cette séquence permet d'éviter de perdre des heures en configuration réseau alors que le goulot d'étranglement se situe plutôt dans la configuration du transport HTTP/3.
HTTP/3 n'est pas systématiquement plus rapide que HTTP/2.
L'une des erreurs les plus fréquentes en matière d'optimisation web consiste à associer la dernière version d'un protocole à une amélioration automatique des performances.
HTTP/3 offre des avantages technologiques significatifs.
QUIC évite le blocage en tête de file de la couche transport entre les flux typique de TCP, intègre le transport sécurisé avec TLS, permet la migration de connexion et est conçu en tenant compte des réseaux modernes, mobiles et volatils.
Mais aucun de ces avantages ne signifie :
HTTP/3 > HTTP/2
dans chaque critère de référence.
Le module HTTP/3 de NGINX est toujours explicitement décrit dans la documentation officielle comme expérimental , avec la mise en garde qui l'accompagne.
De plus, les performances de QUIC dépendent d'éléments que nous pourrions souvent ignorer dans le monde HTTP/2 :
- tampon par flux ;
- contrôle de la congestion QUIC ;
- RTT;
- perte de paquets ;
- Déchargement UDP ;
- comportement du noyau ;
- Dimensionnement BDP ;
- Implémentation spécifique au serveur.
NGINX a lui-même publié des benchmarks montrant que le réglage du contrôle de congestion QUIC produit des différences très significatives en faisant varier le RTT et le BDP, en utilisant pour ces tests un http3_stream_buffer_size bien plus élevé que la valeur par défaut.
L'intérêt du débogage par exclusion
Ce cas illustre également bien la manière dont un problème de performance doit être traité.
Au début, nous avions une description très générique :
« Les fichiers se téléchargent lentement depuis le navigateur. »
Un rapport comme celui-ci pourrait mener à des dizaines de conclusions.
La première transformation majeure a été :
« Chrome est lent, l'application de bureau ne l'est pas. »
Puis:
« HTTP/1.1 et HTTP/2 sont rapides, HTTP/3 est lent. »
Et puis encore :
« Le fichier est statique et le comportement suit exclusivement le protocole. »
Enfin:
« Le débit HTTP/3 est étonnamment bon, à 64 Ko par RTT. »
Chaque test éliminait une partie du problème.
C'est la différence entre modifier les configurations au hasard et établir des diagnostics.
Et surtout : ne vous fiez pas uniquement à la configuration que nous voyons.
La deuxième leçon est encore plus intéressante.
Nous avions fixé :
http3_stream_buffer_size 16m;
En observant l'hôte virtuel, tout semblait correct.
Le domaine demandé était celui-ci.
La directive était présente.
NGINX a redémarré sans erreur.
Mais le résultat n'a pas changé.
À ce stade, nous aurions pu conclure :
"Donc
http3_stream_buffer_size« Cela n'a rien à voir avec ça. »
Cela aurait été une conclusion erronée.
Lire :
src/http/ngx_http_request.c
e:
src/http/v3/ngx_http_v3_request.c
a montré quelque chose que la simple lecture nginx.conf Cela ne le rend pas évident.
La séquence était :
default server del socket
↓
inizializzazione HTTP/3
↓
lettura della configurazione QUIC
↓
ngx_quic_run()
C’est seulement à ce moment-là que les mécanismes supplémentaires d’association du nom du serveur et des flux entrent pleinement en jeu.
Le problème n'était pas que la valeur était trop faible.
Le problème était que la valeur que nous pensions avoir modifiée n’était pas celle utilisée au moment crucial de l’initialisation de la connexion QUIC.
La configuration finale
Dans une infrastructure comportant plusieurs hôtes virtuels HTTP/3 sur le même port, pour les paramètres que nous souhaitons rendre communs, nous privilégions donc une configuration comme celle-ci :
http {

```
http3_stream_buffer_size 1m;

...

server {
    listen 192.0.2.10:443 quic reuseport;
    listen 192.0.2.10:443 ssl;

    server_name www.example.com;

    ...
}

server {
    listen 192.0.2.10:443 quic reuseport;
    listen 192.0.2.10:443 ssl;

    server_name example.com;

    ...
}
```

}
La valeur 1m Il ne s'agit que d'un exemple et sa taille doit être adaptée au cas réel.
L'essentiel est que ce paramètre soit systématiquement disponible lors de l'initialisation de QUIC.
Le même raisonnement mérite d'être pris en compte pour d'autres directives de configuration du serveur QUIC, telles que : quic_gso, car dans la source, elle est également stockée dans la structure de configuration QUIC et la valeur par défaut est off.
Cela ne signifie pas que chaque directive doit être déplacée dans le bloc global.
Cela signifie que lorsque plusieurs hôtes virtuels partagent le même écouteur QUIC, il est nécessaire de comprendre quelles informations sont requises dès les premières étapes de la connexion.
Conclusions
Nous avons commencé avec un client qui a téléchargé une archive statique vers :
1,5-2 MB/s
avec Chrome.
La même ressource a été atteinte via HTTP/1.1 ou HTTP/2 :
8-10 MB/s
Nous soupçonnions initialement :
MTU
PMTU
firewall
routing UDP
packet loss
socket buffer
GSO
NIC
kernel
Hetzner
Ce sont toutes des hypothèses parfaitement légitimes.
Le test entrelacé réalisé avec le même Chrome avait cependant démontré quelque chose d'extrêmement précis :
H2 veloce
H3 lento
H2 nuovamente veloce
Le débit HTTP/3 était également étonnamment compatible avec la limite produite par :
64 KB / RTT
La documentation NGINX a confirmé que :
http3_stream_buffer_size 64k;
Il s'agit de la valeur par défaut.
Le code source a également confirmé que cette valeur est stockée dans la configuration QUIC et que la valeur par défaut implémentée lors de la fusion est bien de 65536 octets.
Mais l'étape véritablement décisive est survenue lors de l'analyse du cycle de vie de la connexion.
In ngx_http_init_connection() NGINX démarre à partir de default_server associé à la paire adresse:port et, lorsqu'il reconnaît un écouteur QUIC, appelle immédiatement ngx_http_v3_init_stream().
Dans cette dernière fonction, la configuration HTTP/3 est récupérée à partir du contexte disponible et la structure QUIC est transmise à ngx_quic_run().
C'est pourquoi vous devriez définir une valeur énorme :
http3_stream_buffer_size 16m;
Ce n'est que sur le deuxième hôte virtuel que le résultat est resté inchangé.
Déplacer la configuration dans le contexte global à la place :
http {
http3_stream_buffer_size 1m;
}
La limitation a disparu et HTTP/3 a finalement commencé à transférer des fichiers à une vitesse comparable à celle de HTTP/2.
Ce cas est intéressant non seulement parce qu'il enseigne comment augmenter une marge de sécurité, mais aussi parce qu'il ne se contente pas d'enseigner comment y parvenir.
La véritable leçon est tout autre.
Une configuration syntaxiquement correcte n'est pas nécessairement appliquée à l'étape du protocole où l'on imagine qu'elle le soit.
Lorsqu'on travaille avec des technologies comme QUIC, TLS, HTTP/2 et HTTP/3, la simple connaissance des directives de configuration peut ne pas suffire.
Parfois, il faut remonter jusqu'à la source.
Et c'est juste là, entre un :
default_server->ctx
et un appel à :
ngx_quic_run()
que nous avons constaté la différence entre un téléchargement d'une minute et demie et un téléchargement de quelques secondes.

