
Table des matières de l'article :
Dans l'univers HTTP, nous sommes habitués depuis des décennies à raisonner avec quelques méthodes fondamentales : GET pour récupérer une ressource, POST pour envoyer des données au serveur, PUT pour mettre à jour et DELETE pour supprimer. Cette grammaire, en apparence simple, sous-tend une grande partie du web moderne : sites web, API REST, applications mobiles, services SaaS, microservices, proxys inverses, CDN et systèmes de cache.
Avec l'évolution des applications, une zone grise de plus en plus évidente est apparue : comment gérer correctement les requêtes complexes en lecture seule ? Prenons l'exemple d'une recherche avec de nombreux filtres, d'une requête GraphQL, d'un point de terminaison de reporting, d'une requête avec pagination, tri, plages horaires et conditions imbriquées. Sémantiquement, l'opération est une lecture : le serveur doit renvoyer des données, et non les modifier. L'utilisation de GET semble donc naturelle. Mais d'un point de vue pratique, GET oblige à tout inclure dans l'URL, ce qui entraîne des limitations de longueur, des problèmes d'encodage, une lisibilité médiocre et des risques potentiels pour la confidentialité des journaux.
Pendant des années, la solution la plus courante consistait à utiliser POST, même pour des opérations qui n'étaient en réalité que de simples requêtes. POST permet d'envoyer un corps structuré, tel que du JSON, mais il confère une signification différente au protocole : une requête susceptible de modifier l'état du serveur. Ce détail n'est pas purement théorique. Pour les caches, les proxys, les CDN, les WAF et les clients HTTP, la méthode utilisée est une information cruciale. Utiliser POST pour lire des données implique souvent de renoncer à certaines optimisations offertes par HTTP.
La nouvelle méthode HTTP QUERY , normalisée par la RFC 10008, a été créée précisément pour combler cette lacune : elle permet d’envoyer une requête avec un corps, comme POST, tout en conservant les propriétés d’une requête en lecture seule, comme GET. Autrement dit, QUERY indique au serveur et aux intermédiaires : « J’exécute une requête, je peux inclure un corps, mais je ne demande pas de modification de l’état de la ressource. »
Le problème historique : GET est correct, mais souvent insuffisant
La méthode GET est la plus naturelle pour récupérer des informations via HTTP. Elle est sécurisée car le client ne demande pas au serveur de modifier l'état de la ressource, et elle est idempotente car la répétition de la même requête ne devrait pas entraîner d'effets secondaires différents. De plus, les réponses GET sont facilement gérées par les caches, les navigateurs, les proxys inverses et les CDN.
Le problème survient lorsque la requête devient trop complexe. Une requête comme celle-ci est parfaitement gérable :
GET /prodotti?categoria=hosting&limit=10&sort=prezzo HTTP/1.1
Host: example.com
Mais que se passe-t-il lorsqu'on utilise des dizaines de filtres, avec éventuellement des conditions imbriquées, des tableaux, des dates, des opérateurs logiques, la recherche plein texte, des préférences de tri et des paramètres d'agrégation ? L'URL devient longue, difficile à lire et plus fragile tout au long de la chaîne de diffusion. Les navigateurs, les bibliothèques clientes, les proxys d'entreprise, les équilibreurs de charge, les CDN et les pare-feu applicatifs peuvent présenter des limitations et des comportements différents.
Il existe ensuite un problème souvent négligé : les URL sont très facilement enregistrées . Elles se retrouvent dans les journaux des serveurs web, les journaux des proxys inverses, l’historique du navigateur, les outils d’analyse, les systèmes de surveillance ou les tableaux de bord de débogage. Si la requête contient des données sensibles, même indirectement, les inclure dans la chaîne de requête n’est pas toujours la solution la plus judicieuse.
Pourquoi POST n'a jamais été une solution élégante
La méthode POST résout le problème pratique du corps de la requête. Elle permet d'envoyer des données JSON complexes, une requête GraphQL, une charge utile XML ou un format d'application personnalisé sans avoir à tout compresser dans l'URL. C'est pourquoi de nombreuses API modernes utilisent POST, même pour les opérations en lecture seule.
Le problème est que la méthode POST ne transmet pas au protocole la même sémantique que la méthode GET. Une requête POST peut créer une ressource, mettre à jour un état, démarrer un processus, enregistrer une commande, envoyer un message et produire des effets permanents. Lorsqu'on l'utilise simplement pour interroger des données, le serveur le sait, l'application cliente peut le savoir aussi, mais les intermédiaires HTTP ne peuvent généralement pas le déduire.
Cela signifie que la mise en cache, les nouvelles tentatives automatiques, l'optimisation des proxys et les stratégies CDN se complexifient. Un système intermédiaire ne peut plus considérer la répétition d'une requête POST comme anodine. Il ne peut la traiter aussi facilement qu'une requête GET. Par conséquent, de nombreuses API effectuant de nombreuses lectures finissent par surcharger systématiquement le serveur, même lorsque la réponse serait techniquement réutilisable.
Qu'apporte la requête HTTP ?
QUERY introduit un concept simple mais très puissant : une requête peut avoir un corps, tout en restant en lecture seule. Sa structure est similaire à celle de POST, mais sa sémantique est différente.
QUERY /api/search HTTP/1.1
Host: example.com
Content-Type: application/json
Accept: application/json

{
"q": "hosting linux managed",
"limit": 20,
"sort": "-created_at",
"filters": {
"status": "active",
"type": ["article", "service"]
}
}
Avec QUERY, le contenu de la requête décrit comment interroger la ressource cible . Le serveur traite la requête et renvoie le résultat, sans que le client n'ait à modifier l'état de la ressource. La RFC définit QUERY comme une méthode sécurisée et idempotente : deux propriétés essentielles pour la conception d'API fiables, évolutives et compatibles avec l'infrastructure HTTP.
Cependant, il ne faut pas confondre QUERY avec un nouveau format de données. QUERY n'impose ni JSON, ni SQL, ni GraphQL, ni JSONPath. Le format est déclaré via l'en-tête Content-Type . Cette flexibilité permet à chaque application de choisir le langage de requête le plus adapté, pourvu que le client et le serveur s'accordent sur la signification des données.
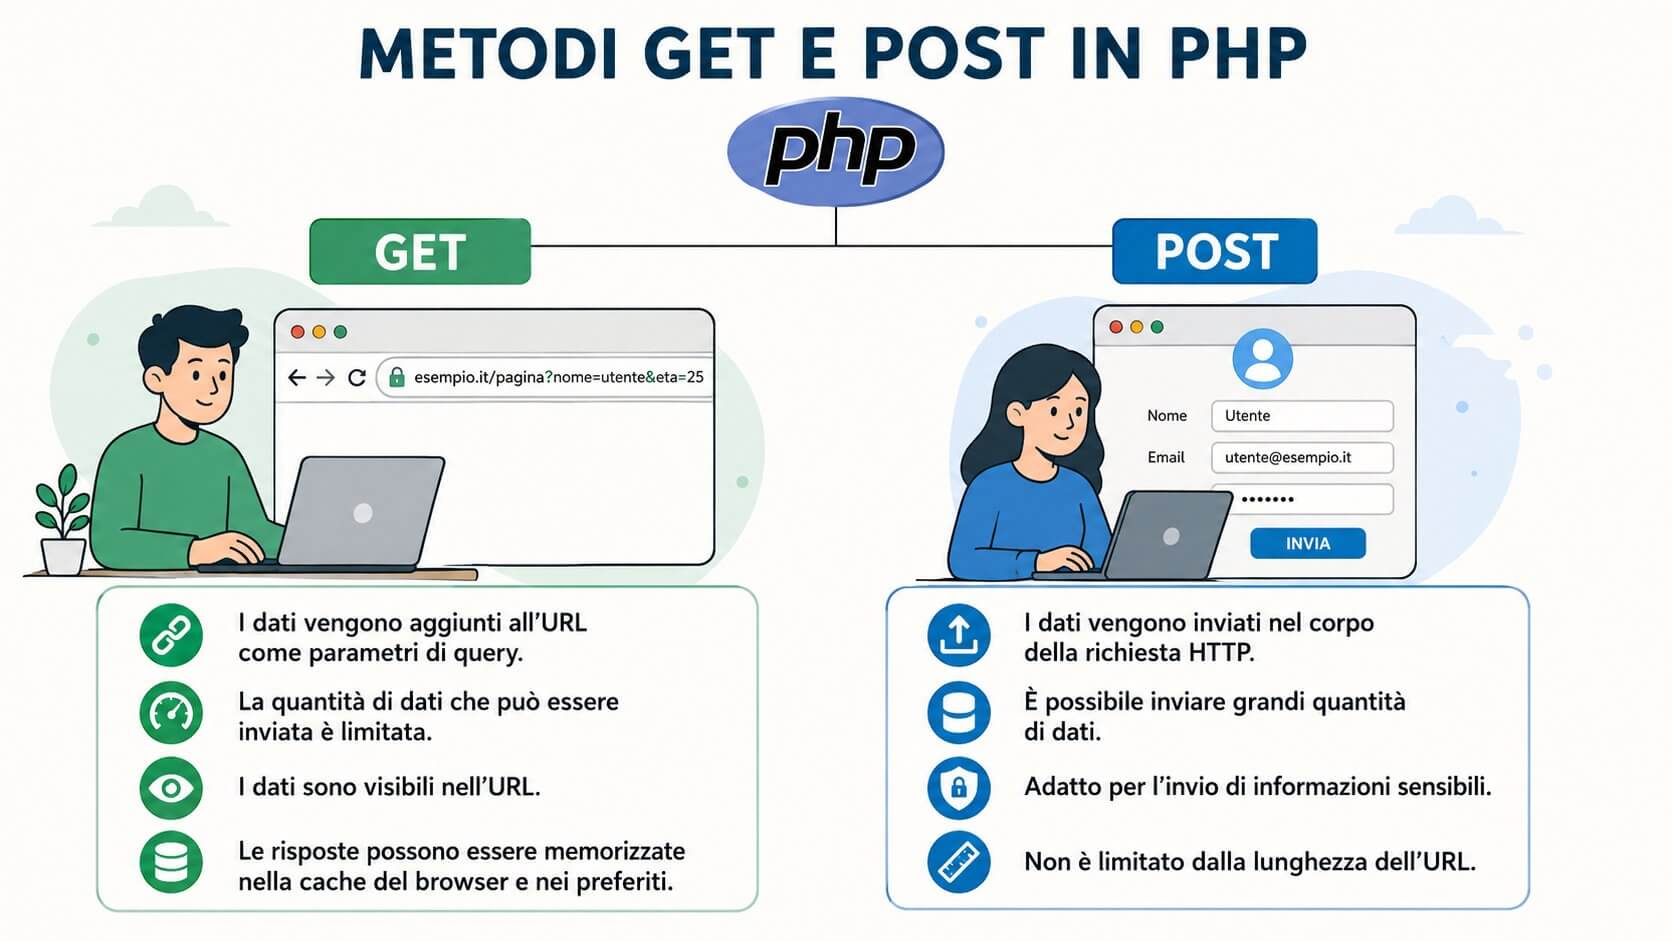
Comparaison des requêtes GET, POST et QUERY
| propriété | ÉCONOMISEZ | POSTEZ | QUERY |
|---|---|---|---|
| Assurer | Oui | Pas nécessairement | Oui |
| Idempotent | Oui | Pas nécessairement | Oui |
| Corps de la requête | Aucune sémantique générale n'est définie. | Oui | Oui |
| Adapté aux requêtes complexes | Seulement dans certaines limites pratiques | Oui, mais avec une sémantique ambiguë. | Oui, avec une sémantique correcte. |
| Mise en cache | Oui | Avec de fortes limitations pratiques | Oui |
La principale différence réside précisément dans le fait que QUERY combine le corps de la requête POST avec la sémantique de la requête GET . Cela peut paraître un détail subtil, mais pour ceux qui travaillent sur des API à fort trafic, des architectures de microservices ou des infrastructures distribuées, cela peut faire toute la différence.
Le rôle de l'en-tête Accept-Query
La RFC introduit également l' en-tête Accept-Query , conçu pour permettre à une ressource de déclarer les formats de requêtes qu'elle prend en charge. Ce mécanisme de découverte est utile car il évite au client d'avoir à deviner.
HTTP/1.1 200 OK
Allow: GET, QUERY
Accept-Query: application/json, application/graphql
Dans cet exemple, le serveur indique que la ressource accepte les requêtes QUERY avec des charges utiles JSON ou GraphQL. Pour un client bien conçu, cette information est précieuse : elle lui permet de choisir le format approprié, de gérer les cas de figure et de générer des messages d’erreur plus clairs lorsque le format n’est pas pris en charge.
La présence de l'en-tête Accept-Query est également intéressante du point de vue de l'infrastructure. Dans un environnement composé de passerelles API, de proxys inverses et de services backend, la possibilité de déclarer explicitement la prise en charge des formats de requêtes contribue à concevoir des contrats plus clairs entre les différents composants.
Cache et proxy inverse : là où les requêtes deviennent vraiment intéressantes
L'intérêt pratique de QUERY se révèle pleinement lorsqu'il s'agit de mise en cache. Une requête GET est généralement identifiée par son URI. Avec QUERY, en revanche, le cache doit également prendre en compte le contenu de la requête et les métadonnées pertinentes, telles que l'en-tête Content-Type et les autres en-têtes influençant le résultat.
Cela permet la mise en cache de plusieurs réponses pour un même point de terminaison, en les distinguant par le corps de la requête. Deux requêtes QUERY identiques peuvent être servies depuis le cache ; deux requêtes QUERY différentes adressées au même point de terminaison doivent générer des clés de cache différentes.
Pour une infrastructure moderne, cela ouvre des perspectives intéressantes :
- réduction de la charge de l'application sur les résultats de la recherche ou du compte rendu ;
- meilleure exploitation des proxys inverses et des CDN devant les API en lecture seule ;
- des tentatives plus sûres en cas d'erreurs réseau temporaires ;
- sémantique plus claire entre le client, la passerelle et le serveur.
Bien sûr, une méthode standardisée ne suffit pas à garantir un fonctionnement immédiat. Chaque élément de la chaîne doit la reconnaître, ou au moins la transmettre correctement : serveurs web, proxys, équilibreurs de charge, CDN, WAF, frameworks applicatifs et bibliothèques clientes.
Attention à l'adoption : la normalisation n'implique pas un soutien immédiat
Il est important de distinguer la normalisation de l'adoption effective . Le fait que QUERY ait été défini comme une RFC et enregistré par l'IANA ne signifie pas que tous les navigateurs, frameworks, CDN ou pare-feu le gèrent déjà de manière optimale.
Dans les infrastructures réelles, des règles explicites encadrent souvent les méthodes HTTP autorisées. Un pare-feu applicatif web (WAF) peut n'autoriser que les méthodes GET, POST, HEAD, OPTIONS, PUT et DELETE. Un proxy inverse peut présenter des configurations restrictives. Une application ancienne peut renvoyer une erreur pour une méthode inconnue. Un système de journalisation peut ne pas identifier correctement la nouvelle requête.
Pour cette raison, QUERY doit être considérée comme une technologie qui doit être soigneusement évaluée, notamment dans des contextes contrôlés : communications serveur à serveur, API internes, environnements de test, microservices sous le même domaine d’exploitation, points de terminaison de recherche à fort trafic où les clients et les serveurs sont gérés par la même organisation.
Qu'est-ce que cela signifie pour ceux qui gèrent l'hébergement, les serveurs Linux et les API de production ?
Du point de vue des systèmes, QUERY n'est pas qu'une simple nouveauté pour les développeurs. C'est un changement qui impacte également les administrateurs d'infrastructure. Si une application commence à utiliser QUERY, il est essentiel de s'assurer que l'ensemble de la chaîne est prêt à recevoir et à transmettre correctement cette nouvelle méthode.
Dans un environnement Linux avec serveurs web, proxys inverses et pare-feu applicatifs, les principaux contrôles portent au moins sur les aspects suivants : configurations Nginx ou Apache, règles WAF, politiques CORS, journalisation, métriques, systèmes APM, équilibreurs de charge, CDN et outils de sécurité. Une méthode HTTP inconnue ou non explicitement autorisée peut être bloquée avant même d’atteindre l’application.
Il est également important de prendre en compte la mise en cache. Si un proxy inverse ou un CDN met en cache les réponses aux requêtes, la clé de cache doit inclure le contenu de la requête et les métadonnées correctes. Une normalisation incorrecte pourrait entraîner des résultats erronés. À l'inverse, une configuration trop restrictive pourrait annuler les avantages de la nouvelle méthode.
En d'autres termes, QUERY peut s'avérer très utile, mais son intégration doit être envisagée dans le cadre d'une conception d'infrastructure réfléchie. Il ne s'agit pas d'un simple changement de verbe au niveau du code : cela requiert des tests, une observabilité et des règles cohérentes sur l'ensemble de la plateforme.
Un exemple pratique avec curl
Un client peut envoyer une requête QUERY comme celle-ci :
curl -X QUERY "https://api.example.com/search"
-H "Content-Type: application/json"
-H "Accept: application/json"
--data '{
"q": "server managed linux",
"limit": 10,
"sort": "-published_at"
}'
Du point de vue de l'application, le serveur reçoit une charge utile structurée. Sémantiquement, cependant, la requête n'est pas une requête POST générique : il s'agit d'une requête sécurisée et idempotente. C'est le cœur même de la norme.
La méthode QUERY va-t-elle remplacer GET ou POST ?
Non. QUERY n'a pas été créé pour remplacer GET ou POST, mais pour répondre à un besoin qui, jusqu'à présent, nécessitait des compromis. GET reste idéal pour les requêtes simples, les ressources directement identifiables par leur URL et le contenu facilement mis en cache. POST demeure la méthode appropriée lorsque le client envoie des données susceptibles de créer, modifier ou déclencher un traitement ayant un impact sur le serveur.
QUERY se situe entre les deux : il convient lorsqu’il est nécessaire d’exécuter une requête complexe en lecture seule avec un corps . Il est donc particulièrement intéressant pour les API de recherche, GraphQL, les points de terminaison analytiques, les rapports, les agrégations et les services internes qui interrogent de grandes quantités de données sans les modifier.
conclusion
La méthode HTTP QUERY est une nouveauté importante car elle corrige un défaut pratique bien connu des développeurs : l’utilisation de GET lorsque la requête ne tient pas dans l’URL, ou de POST lorsqu’elle perd en clarté sémantique et en avantages d’infrastructure. Avec QUERY, HTTP offre enfin une méthode conçue pour les requêtes complexes, sécurisées, idempotentes et pouvant être mises en cache.
Pour les développeurs d'API, cela signifie pouvoir concevoir des points de terminaison plus cohérents. Pour les administrateurs d'infrastructures Linux, de proxys inverses, de CDN et d'environnements gérés, cela implique de se préparer à prendre en charge une nouvelle méthode HTTP avec les configurations, les tests et les politiques appropriés.
Comme c'est souvent le cas avec les normes, l'impact ne sera pas immédiat. L'adoption nécessitera du temps, des mises à jour et une compatibilité tout au long de la chaîne. Mais la direction est claire : QUERY rend HTTP plus expressif, plus correct et mieux adapté aux API modernes.
Chez Managed Server, nous suivons de près ces évolutions car elles ont un impact direct sur les performances, la sécurité, la mise en cache et la fiabilité des applications web. Une infrastructure bien gérée ne se contente pas d'héberger un site web ou une API : elle doit également être prête à adopter de manière sécurisée et sereine les standards qui contribuent à l'amélioration du web.

