

Table des matières de l'article :
Dans le paysage moderne du e-commerce, chaque milliseconde compte. En matière de performances web et de positionnement dans les moteurs de recherche, la vitesse d'un site n'est plus une option, mais une exigence fondamentale. C'est particulièrement vrai pour les sites à fort trafic comme inventivashop.com, qui domine la première place sur Google pour des mots clés compétitifs tels que « Signs ».
Le site en question constitue un excellent exemple de la façon dont une infrastructure déjà largement optimisée peut masquer des goulots d'étranglement critiques qui, une fois identifiés et résolus, entraînent des améliorations de performances spectaculaires. Dans cet article technique, nous partagerons notre approche méthodique pour optimiser une requête SQL particulièrement problématique, en illustrant comment nous y sommes parvenus. une amélioration des performances de 99,83 % — de 1,8 seconde à seulement 3 millisecondes.
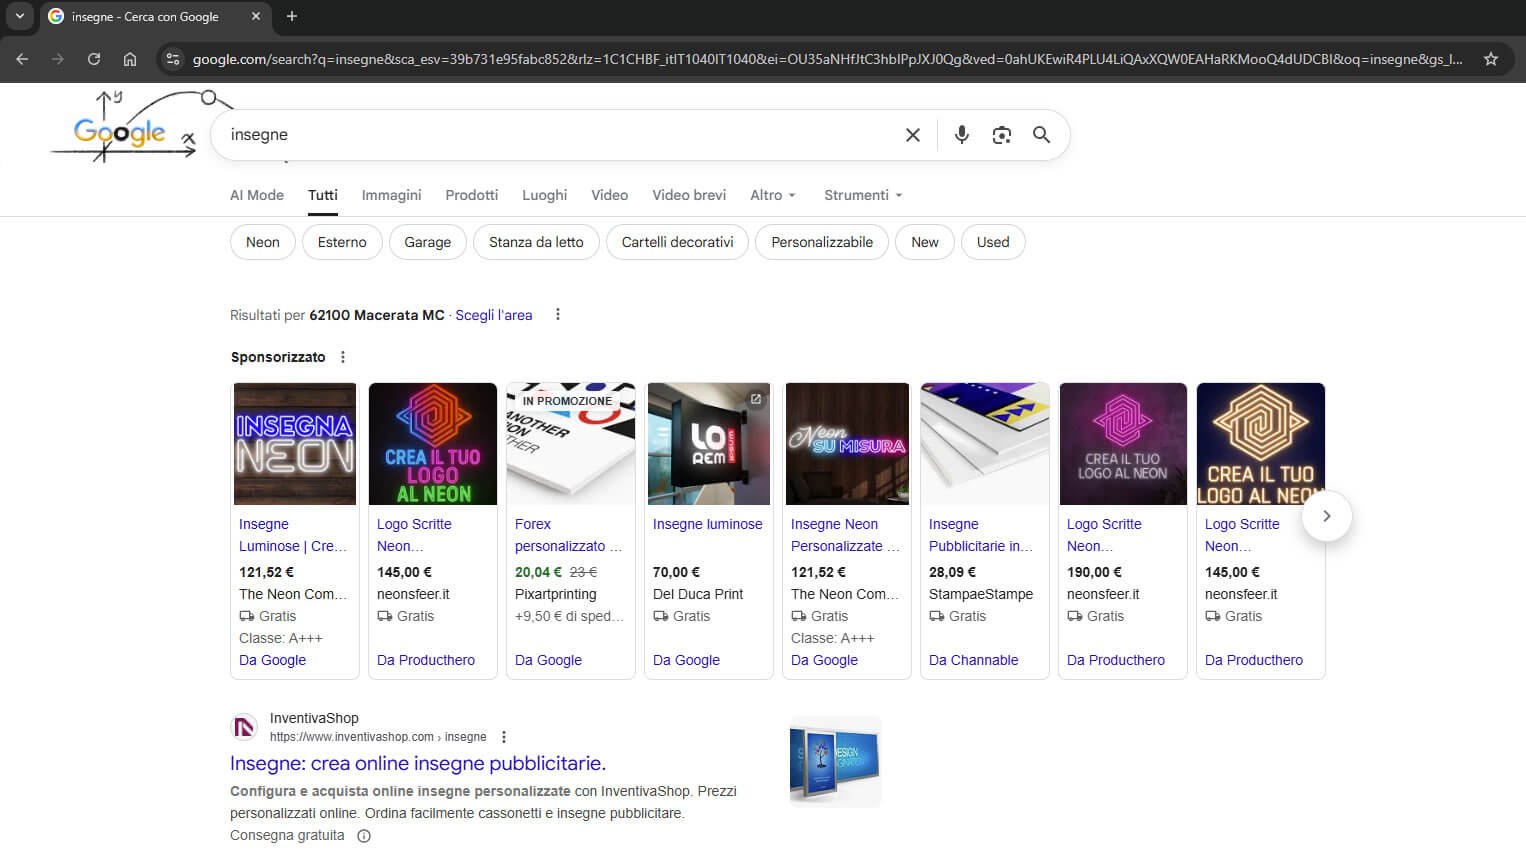
Le contexte : une infrastructure déjà de premier ordre
Avant d'aborder le cas spécifique, il est important de noter qu'inventivashop.com n'est pas parti de zéro en matière d'optimisation. Le site bénéficiait déjà d'un arsenal complet de technologies et de bonnes pratiques :
Pile technologique de pointe
- HTTP / 3: Protocole de nouvelle génération pour des connexions plus rapides et plus résilientes
- Compression ZSTD: Compression avancée pour réduire la charge utile de la réponse
- Optimisé NGINX:Réglage au niveau du serveur Web avec des configurations personnalisées pour des performances maximales
- Certificats TLS compressés:Réduction des frais généraux SSL/TLS
- Prise en charge WebP: Images de nouvelle génération avec une taille de fichier jusqu'à 30 % plus petite
- Vitaux Web de base optimisé:Toutes les bonnes pratiques mises en œuvre pour LCP, FID, CLS
- Serveur Percona 5.7: Serveur de base de données optimisé au lieu de MySQL classique
Ce dernier point mérite une attention particulière. Le choix de Percona Server 5.7, bien qu'en fin de vie depuis novembre 2024 , n'était pas accidentel mais le résultat de tests comparatifs approfondis qui ont mis en évidence des performances supérieures à celles de MariaDB pour les requêtes spécifiques du site.
Le choix controversé : Percona Server 5.7 en fin de vie
Au cours des tests préliminaires, nous avons identifié une requête critique qui présentait un comportement radicalement différent selon les moteurs de base de données :
- MariaDB 10.x: 1.700-1.800 ms
- MySQL 8.0: 1.500-1.600 ms
- Serveur Percona 5.7: 200 ms
La différence était si marquée (environ 9 fois plus rapide ) que nous avons dû prendre une décision difficile : utiliser une version en fin de vie mais avec des performances nettement supérieures, tout en mettant en œuvre toutes les mesures de sécurité nécessaires (isolation du réseau, durcissement, surveillance continue).
Le problème : quand un seul module met le site à genoux
Malgré toutes ces optimisations, la surveillance des performances a continué de mettre en évidence un problème récurrent et important. Les indicateurs affichaient des pics de latence inexpliqués, et le temps de réponse au premier octet (TTFB) était largement supérieur à nos normes sur certaines pages.
Le module BlockLayered : essentiel mais lourd
Le coupable s'est avéré être le module blocklayered de PrestaShop (renommé « Faceted Search » dans les versions plus récentes). Ce module est essentiel pour tout site e-commerce moderne car il gère :
- Filtres de catégorie (prix, couleur, taille, marque, etc.)
- Navigation produit à facettes
- Nombre de produits dynamiques pour chaque filtre
- Agrégations et arrangements complexes
Le module est appelé sur pratiquement toutes les pages de catégorie, de recherche ou de fiche produit, c'est-à-dire sur les pages les plus visitées d'un site e-commerce. Son inefficacité impacte donc l'expérience utilisateur dans son ensemble et, par conséquent, les taux de conversion.
La découverte : 1,8 seconde pour une seule requête
Grâce à une analyse systématique des journaux de requêtes lentes et à l'utilisation de l' outil Percona Toolkit (pt-query-digest), nous avons identifié la requête problématique. Les chiffres étaient alarmants :
- Temps d'exécution moyen: 1.700-1.800 ms
- Frequenza:Des milliers de fois par jour
- Impact total:Des dizaines de minutes de temps CPU gaspillé chaque heure
- Patron de Couture:Présent dans chaque catégorie de navigation avec filtres
Pour information : dans une architecture bien optimisée, les requêtes de lecture du catalogue de produits devraient prendre entre 10 et 50 ms. Une requête qui prend près de 2 secondes est environ 40 à 180 fois plus lente que prévu.
L'approche diagnostique
Nous aurions pu utiliser des solutions de surveillance des performances applicatives (APM) comme New Relic, qui nous auraient fourni une vue globale des performances applicatives. Cependant, compte tenu de la nature concentrée du problème (une requête unique, très fréquente et très lente), nous avons opté pour une approche plus ciblée :
- Activation du journal des requêtes lentes sur le serveur Percona
- Collecte de données pendant 24-48 heures
- Analyse avec pt-query-digest pour identifier les modèles et normaliser les requêtes
- EXPLIQUER ANALYSER pour comprendre le plan d'exécution
- Profilage de la requête spécifique pour identifier les goulots d'étranglement
Cette approche nous a permis de concentrer toutes les ressources sur la résolution du vrai problème sans gaspillage.
La question problématique : anatomie d'un désastre de performance
Voici la requête originale générée par le module blocklayered. Le module blocklayered di PrestaShop — maintenant connu dans des versions plus récentes sous le nom de « Recherche à facettes » o « Recherche par couches » — est l’un des modules fondamentaux pour le navigation produit filtrée au sein d'une catégorie, d'une page de recherche ou d'une sélection de produits (par exemple, fabricant, attribut, balise, etc.).
SELECT
    p.*,
    product_shop.*,
    stock.out_of_stock,
    IFNULL(stock.quantity, 0) AS quantity,
    MAX(product_attribute_shop.id_product_attribute) AS id_product_attribute,
    product_attribute_shop.minimal_quantity AS product_attribute_minimal_quantity,
    pl.`description`,
    pl.`description_short`,
    pl.`available_now`,
    pl.`available_later`,
    pl.`link_rewrite`,
    pl.`meta_description`,
    pl.`meta_keywords`,
    pl.`meta_title`,
    pl.`name`,
    MAX(image_shop.`id_image`) AS id_image,
    isecond.`id_image` AS id_image_second,
    il.`legend`,
    m.`name` AS manufacturer_name,
    cl.`name` AS category_default,
    DATEDIFF(product_shop.`date_add`, DATE_SUB(NOW(), INTERVAL 20 DAY)) > 0 AS new,
    product_shop.price AS orderprice,
    cp.position

FROM
    `ps_category_product` cp  -- Tabella di join Categoria-Prodotto
LEFT JOIN
    `ps_product` p ON p.`id_product` = cp.`id_product`  -- Informazioni base del Prodotto
INNER JOIN
    ps_product_shop product_shop
    ON (
        product_shop.id_product = p.id_product
        AND product_shop.id_shop = 1
    )  -- Informazioni specifiche del Prodotto per lo Shop (necessario)
LEFT JOIN
    `ps_product_attribute` pa ON (p.`id_product` = pa.`id_product`)  -- Attributi del Prodotto (combinazioni)
LEFT JOIN
    ps_product_attribute_shop product_attribute_shop
    ON (
        product_attribute_shop.id_product_attribute = pa.id_product_attribute
        AND product_attribute_shop.id_shop = 1
        AND product_attribute_shop.`default_on` = 1
    )  -- Attributi dello Shop (solo default)
LEFT JOIN
    ps_stock_available stock
    ON (
        stock.id_product = p.id_product
        AND stock.id_product_attribute = IFNULL(`product_attribute_shop`.id_product_attribute, 0)
        AND stock.id_shop = 1
    )  -- Stock disponibile
LEFT JOIN
    `ps_category_lang` cl
    ON (
        product_shop.`id_category_default` = cl.`id_category`
        AND cl.`id_lang` = 6
        AND cl.id_shop = 1
    )  -- Nome della Categoria di default (lingua 6)
LEFT JOIN
    `ps_product_lang` pl
    ON (
        p.`id_product` = pl.`id_product`
        AND pl.`id_lang` = 6
        AND pl.id_shop = 1
    )  -- Dati descrittivi del Prodotto (lingua 6)
LEFT JOIN
    `ps_image` i ON (i.`id_product` = p.`id_product`)  -- Tutte le immagini
LEFT JOIN
    ps_image_shop image_shop
    ON (
        image_shop.id_image = i.id_image
        AND image_shop.id_shop = 1
        AND image_shop.cover = 1
    )  -- Immagine di copertina per lo Shop
LEFT JOIN
    `ps_image` isecond
    ON (
        isecond.`id_product` = p.`id_product`
        AND isecond.position = 2
    )  -- Immagine in seconda posizione
LEFT JOIN
    `ps_image_lang` il
    ON (
        image_shop.`id_image` = il.`id_image`
        AND il.`id_lang` = 6
    )  -- Legenda dell'immagine di copertina (lingua 6)
LEFT JOIN
    `ps_manufacturer` m ON m.`id_manufacturer` = p.`id_manufacturer`  -- Nome del Produttore

WHERE
    product_shop.`id_shop` = 1  -- Filtro per lo Shop
    AND cp.`id_category` = 66  -- Filtro per la Categoria specifica
    AND product_shop.`active` = 1  -- Solo prodotti attivi
    AND product_shop.`visibility` IN ("both", "catalog")  -- Solo prodotti visibili in catalogo o ovunque

GROUP BY
    product_shop.id_product

ORDER BY
    cp.`position` ASC

LIMIT 0, 50;  -- Limite di risultati (offset 0, 50 righe)
Qu'est-ce qui rend cette requête si lente ?
En analysant la requête « EXPLAIN », plusieurs problèmes critiques sont apparus :
1. GROUP BY sur une table avec de nombreuses lignes : L'opération de regroupement sur `product_shop.id_product` nécessite le tri de toutes les lignes intermédiaires générées par les JOIN, une opération O(n log n) sur des ensembles de données potentiellement volumineux.
2. Fonctions d'agrégation MAX() sur JOIN : Les deux fonctions `MAX()` — sur `product_attribute_shop.id_product_attribute` et `image_shop.id_image` — forcent la base de données à :
- Effectuer toutes les jointures
- Regrouper par produit
- Calculer le maximum pour chaque groupe
Ce modèle est particulièrement inefficace lorsqu’un produit comporte de nombreuses variantes ou de nombreuses images.
3. Cascade de jointures externes gauches : La cascade de 11 jointures externes gauches crée un produit cartésien de très grande taille. Pour un produit contenant :
- 10 variantes (product_attribute)
- images 5
- Données multilingues
Potentiellement, plus de 50 lignes intermédiaires sont générées et doivent ensuite être regroupées.
4. Absence de filtres dans les sous-requêtes : aucun préfiltrage n’est effectué. La base de données doit traiter TOUTES les variantes de TOUS les produits avant l’application des filtres.
5. Table temporaire et tri de fichiers : La commande `EXPLAIN` a affiché : Utilisation d'une table temporaire ; Utilisation du tri de fichiers
Deux signes indiquant que la base de données doit créer des tables temporaires et les trier sur le disque — des opérations très coûteuses.
Le coût caché de GROUP BY
Il GROUP BY dans cette requête, c'est particulièrement délicat car :
- Impossible d'utiliser les index efficacement (le tri est différent du regroupement)
- Nécessite des tampons de mémoire importants (ou des débordements de disque)
- Il doit traiter toutes les lignes avant de pouvoir renvoyer même le premier résultat.
- Empêche les optimisations telles que « l'analyse d'index lâche »
Avec un catalogue de 10 000 produits et 50 000 variantes, cette requête pourrait générer temporairement des millions de lignes intermédiaires.
La solution : réécrire la requête pour éliminer les anti-modèles
Après des jours d'analyse, de benchmarking et d'itérations, nous sommes arrivés à cette requête optimisée mais très, très, très, très, très, très, très longue :
SELECT
    p.*,
    product_shop.*,
    stock.out_of_stock,
    IFNULL(stock.quantity, 0) AS quantity,
    pa_default.id_product_attribute,
    pa_default.minimal_quantity AS product_attribute_minimal_quantity,
    pl.`description`,
    pl.`description_short`,
    pl.`available_now`,
    pl.`available_later`,
    pl.`link_rewrite`,
    pl.`meta_description`,
    pl.`meta_keywords`,
    pl.`meta_title`,
    pl.`name`,
    img_cover.id_image AS id_image,
    isecond.`id_image` AS id_image_second,
    il.`legend`,
    m.`name` AS manufacturer_name,
    cl.`name` AS category_default,
    DATEDIFF(product_shop.`date_add`, DATE_SUB(NOW(), INTERVAL 20 DAY)) > 0 AS new,
    product_shop.price AS orderprice,
    cp.position

FROM
    `ps_category_product` cp  -- Tabella di join Categoria-Prodotto
INNER JOIN
    `ps_product_shop` product_shop
    ON (
        product_shop.id_product = cp.id_product
        AND product_shop.id_shop = 1
    )  -- Informazioni specifiche del Prodotto per lo Shop
INNER JOIN
    `ps_product` p
    ON p.`id_product` = cp.`id_product`  -- Informazioni base del Prodotto
LEFT JOIN
    (
        -- Subquery per l'attributo di prodotto predefinito (default)
        SELECT
            pa.id_product,
            pa.id_product_attribute,
            pas.minimal_quantity
        FROM
            ps_product_attribute pa
        INNER JOIN
            ps_product_attribute_shop pas
            ON (
                pas.id_product_attribute = pa.id_product_attribute
                AND pas.id_shop = 1
                AND pas.`default_on` = 1
            )
    ) pa_default ON pa_default.id_product = p.id_product
LEFT JOIN
    ps_stock_available stock
    ON (
        stock.id_product = p.id_product
        AND stock.id_product_attribute = IFNULL(pa_default.id_product_attribute, 0)
        AND stock.id_shop = 1
    )  -- Stock disponibile (collegato all'attributo di default)
LEFT JOIN
    `ps_category_lang` cl
    ON (
        product_shop.`id_category_default` = cl.`id_category`
        AND cl.`id_lang` = 6
        AND cl.id_shop = 1
    )  -- Nome della Categoria di default (lingua 6)
LEFT JOIN
    `ps_product_lang` pl
    ON (
        p.`id_product` = pl.`id_product`
        AND pl.`id_lang` = 6
        AND pl.id_shop = 1
    )  -- Dati descrittivi del Prodotto (lingua 6)
LEFT JOIN
    (
        -- Subquery per l'immagine di copertina (cover)
        SELECT
            i.id_product,
            i.id_image
        FROM
            ps_image i
        INNER JOIN
            ps_image_shop image_shop
            ON (
                image_shop.id_image = i.id_image
                AND image_shop.id_shop = 1
                AND image_shop.cover = 1
            )
        WHERE
            i.id_product IN (
                SELECT
                    cp2.id_product
                FROM
                    ps_category_product cp2
                WHERE
                    cp2.id_category = 66
            )  -- Filtra le immagini solo per i prodotti della categoria 66
    ) img_cover ON img_cover.id_product = p.id_product
LEFT JOIN
    `ps_image` isecond
    ON (
        isecond.`id_product` = p.`id_product`
        AND isecond.position = 2
    )  -- Immagine in seconda posizione
LEFT JOIN
    `ps_image_lang` il
    ON (
        img_cover.`id_image` = il.`id_image`
        AND il.`id_lang` = 6
    )  -- Legenda dell'immagine di copertina (lingua 6)
LEFT JOIN
    `ps_manufacturer` m
    ON m.`id_manufacturer` = p.`id_manufacturer`  -- Nome del Produttore

WHERE
    cp.`id_category` = 66  -- Filtro per la Categoria specifica
    AND product_shop.`active` = 1  -- Solo prodotti attivi
    AND product_shop.`visibility` IN ("both", "catalog")  -- Solo prodotti visibili in catalogo o ovunque

ORDER BY
    cp.`position` ASC

LIMIT 50;  -- Limite di risultati (inizia da 0 per default)
Anatomie des optimisations
Examinons de plus près ce qui rend cette requête si efficace :
1. Éliminez complètement GROUP BY
Prima: GROUP BY product_shop.id_product
Après: Pas de GROUP BY
Il s'agit du changement le plus impactant. En supprimant GROUP BY, nous évitons :
- Création de tables temporaires
- Tri intermédiaire de millions de lignes potentielles
- Déversement de disque lorsque les tampons de mémoire sont insuffisants
2. Remplacement de MAX() par des sous-requêtes ciblées
Pour les attributs du produit :
— AVANT : MAX(product_attribute_shop.id_product_attribute)
— Avec JOIN qui génère N lignes par produit
— AFTER : Sous-requête qui renvoie directement l'attribut par défaut
LEFT JOIN
    (
        SELECT
            pa.id_product,
            pa.id_product_attribute,
            pas.minimal_quantity
        FROM
            ps_product_attribute pa
        INNER JOIN
            ps_product_attribute_shop pas
            ON (
                pas.id_product_attribute = pa.id_product_attribute
                AND pas.id_shop = 1
                AND pas.`default_on` = 1
            )
    ) pa_default
ON
    pa_default.id_product = p.id_product
avantages:
- La sous-requête est exécutée seulement une fois et matérialisé
- Renvoie exactement une ligne par produit (merci au filtre
default_on = 1) - MySQL peut utiliser des index sur la colonne
default_on - Aucune fonction d'agrégation à calculer
Pour les images de couverture :
— AVANT : MAX(image_shop.id_image)
— Avec LEFT JOIN sur toutes les images
— APRES : Sous-requête pré-filtrée
LEFT JOIN
    (
        SELECT
            i.id_product,
            i.id_image
        FROM
            ps_image i
        INNER JOIN
            ps_image_shop image_shop
            ON (
                image_shop.id_image = i.id_image
                AND image_shop.id_shop = 1
                AND image_shop.cover = 1  -- Solo cover
            )
        WHERE
            i.id_product IN (
                SELECT
                    cp2.id_product
                FROM
                    ps_category_product cp2
                WHERE
                    cp2.id_category = 66  -- Pre-filtro sulla categoria
            )
    ) img_cover
ON
    img_cover.id_product = p.id_product
avantages:
- Filtrer
cover = 1sélectionnez uniquement l'image de couverture déjà - Le pré-filtrage sur les produits de catégorie réduit considérablement les lignes traitées
- La sous-requête est exécutée en premier et son résultat est réutilisé
- Renvoie exactement une ligne par produit
3. Pré-filtrage stratégique
La sous-requête d'image inclut ce filtre préliminaire :
WHERE
    i.id_product IN (
        SELECT
            cp2.id_product
        FROM
            ps_category_product cp2
        WHERE
            cp2.id_category = 66
    )
Avec un catalogue de 10 000 produits dont seulement 150 sont dans la catégorie 66 :
- Prima: Images traitées de tous les 10 000 produits (plus de 50 000 images)
- Après: Traiter uniquement les images des 150 produits pertinents (750 images)
Réduction de 98,5 % du nombre de lignes traitées à cette étape.
4. Ordre JOIN optimisé
Prima:Ça a commencé à partir de ps_category_product avec un LEFT JOIN sur ps_product
Après :
FROM `ps_category_product` cp
INNER JOIN `ps_product_shop` product_shop ON ...
INNER JOIN `ps_product` p ON ...
En utilisant INNER JOIN pour les tables clés, nous forçons l'optimiseur de requêtes à :
- Appliquer d'abord les filtres à la catégorie
- Considérez uniquement les produits actifs et visibles
- Réduisez considérablement l'ensemble de données avant d'effectuer des jointures gauches facultatives
5. Matérialisation des sous-requêtes
MySQL/Percona peut matérialiser des sous-requêtes dans la clause FROM, créant ainsi de très petites requêtes temporaires indexées. Dans notre cas :
Sous-requête pa_default : ~500 lignes (une par produit avec variantes)
Sous-requête img_cover : ~150 lignes (uniquement les produits de catégorie avec images)
Ces tables temporaires sont si petites qu'elles restent en mémoire (pool de mémoire tampon InnoDB) et les jointures ultérieures deviennent des opérations O(1) via une jointure de hachage ou une recherche d'index.
Le paradoxe des sous-requêtes : plus simple, plus rapide
Il existe une idée fausse répandue selon laquelle les sous-requêtes sont toujours plus lentes que les jointures directes. C'était en partie vrai dans les anciens moteurs de base de données (MySQL 5.1 et versions antérieures), mais ce n'est plus le cas dans les moteurs modernes.
Pourquoi les sous-requêtes bien écrites sont plus rapides :
1. Portée réduiteIls ne traitent que les données nécessaires
2. Matérialisation automatique: L'optimiseur de requêtes crée des requêtes optimisées temporaires
3. Réutiliser:La sous-requête est exécutée une fois, le résultat est réutilisé
4. Meilleure utilisation des indexDes requêtes plus simples permettent des stratégies d'indexation plus efficaces
5. Prévention du produit cartésien:Ils évitent l'explosion combinatoire des lignes
Dans notre cas spécifique, nous avons remplacé une requête par :
0 sous-requêtes
11 JOINT GAUCHE
2 MAX()
1 GROUPER PAR
Avec une requête qui a :
3 sous-requêtes (dont une imbriquée)
8 JOINT GAUCHE
2 JOINTURE INTERNE
0 MAX()
0 GROUPER PAR
Pourtant, ce dernier est 600 fois plus rapide.
Les résultats : 1 800 ms à 3 ms
Les tests ont été réalisés dans des conditions réelles, sur une base de données de production (répliquée dans un environnement de test), obtenant une amélioration de 1,8 seconde à 0,003 seconde (3 millisecondes) comme le montre la vidéo suivante où nous illustrons l'ensemble du processus de test.
L'implémentation : de la base de données au code PHP
L'optimisation de la requête SQL n'était que la moitié du travail. Le véritable défi consistait à intégrer cette requête au module PrestaShop existant tout en maintenant une compatibilité totale avec toutes les fonctionnalités du module à blocs.
Le module blocklayered se trouve à l' emplacement suivant : /modules/blocklayered/blocklayered.php
La requête d'origine était dans la méthode getProductByFilters() de la classe BlockLayered, environ à la ligne 1996.
Adaptation du code PHP
Le changement le plus difficile a été de gérer le fait que la requête optimisée renvoie les mêmes colonnes, mais via des sous-requêtes avec des alias différents. Nous avons dû :
- Mettre à jour la construction de la requête:
$id_shop = (int)Context::getContext()->shop->id; $this->products = Db::getInstance(_PS_USE_SQL_SLAVE_)->executeS(' SELECT p.*, ' . ($alias_where == 'p' ? '' : 'product_shop.*,') . ' pl.`description`, pl.`description_short`, // … altri campi espliciti invece di pl.* img_cover.id_image, // Invece di MAX(image_shop.id_image) pa_default.id_product_attribute, // Invece di MAX(…) // … resto della query '); - Vérifiez la compatibilité des champs renvoyésNous avons dû tester que tous les champs utilisés plus tard dans le code étaient présents avec les mêmes noms et types.
- Gestion des cas limites: Produits sans variantes, produits sans images, etc. La requête optimisée avec des LEFT JOINs bien placés gère déjà ces cas, mais nous avons ajouté des tests spécifiques.
- Maintenir la pagination et le tri: La clause
LIMITeORDER BYdevrait continuer à fonctionner correctement avec les paramètres dynamiques de PrestaShop.
Réflexions et considérations finales
L'excellence exige du temps et de la méthode
Cette intervention représente l'un des cas les plus intéressants d'optimisation « chirurgicale » sur un système en pleine production. Il s'agissait d'un processus précis, étape par étape, qui a exigé du temps, de l'expertise et une grande rigueur. L'ensemble du processus, de l'analyse initiale à la validation finale, ne peut être improvisé : même pour une équipe expérimentée, une telle activité peut nécessiter au minimum deux jours ouvrables complets , et souvent bien plus, compte tenu de la nécessité de diagnostiquer, tester et vérifier chaque modification.
La partie la plus complexe n'était pas l'intervention technique en elle-même, mais plutôt la phase d'étude préliminaire : identifier le goulot d'étranglement, isoler la requête problématique et comprendre l'impact réel de chaque modification possible. S'en est suivi un long processus d'optimisation, exigeant une expertise en SQL , une connaissance approfondie du fonctionnement interne de MySQL/Percona et une bonne maîtrise de l'architecture de PrestaShop.
Il ne s'agit pas seulement d'écrire une requête plus efficace : il est essentiel de comprendre son interaction avec le code PHP, le modèle de données et la logique métier de l'application. Chaque modification doit être rigoureusement testée, à la fois pour vérifier les performances et pour s'assurer qu'elle n'introduit pas de régressions ou de comportements inattendus. Même une petite négligence peut engendrer des problèmes en production ; les tests et la qualité du code deviennent donc aussi cruciaux que l'écriture de la requête elle-même.
Quand est-ce que ça vaut vraiment le coup ?
Une intervention aussi poussée n'est pas toujours justifiée. Elle n'a de sens que dans des conditions spécifiques : un trafic important, un impact financier tangible lié aux performances et un goulot d'étranglement réel et mesurable affectant l'expérience utilisateur ou les conversions. En pratique, cette approche est pertinente lorsque les optimisations les plus courantes ont déjà été mises en œuvre et que les seules marges d'amélioration résident au cœur de la base de données et du code applicatif.
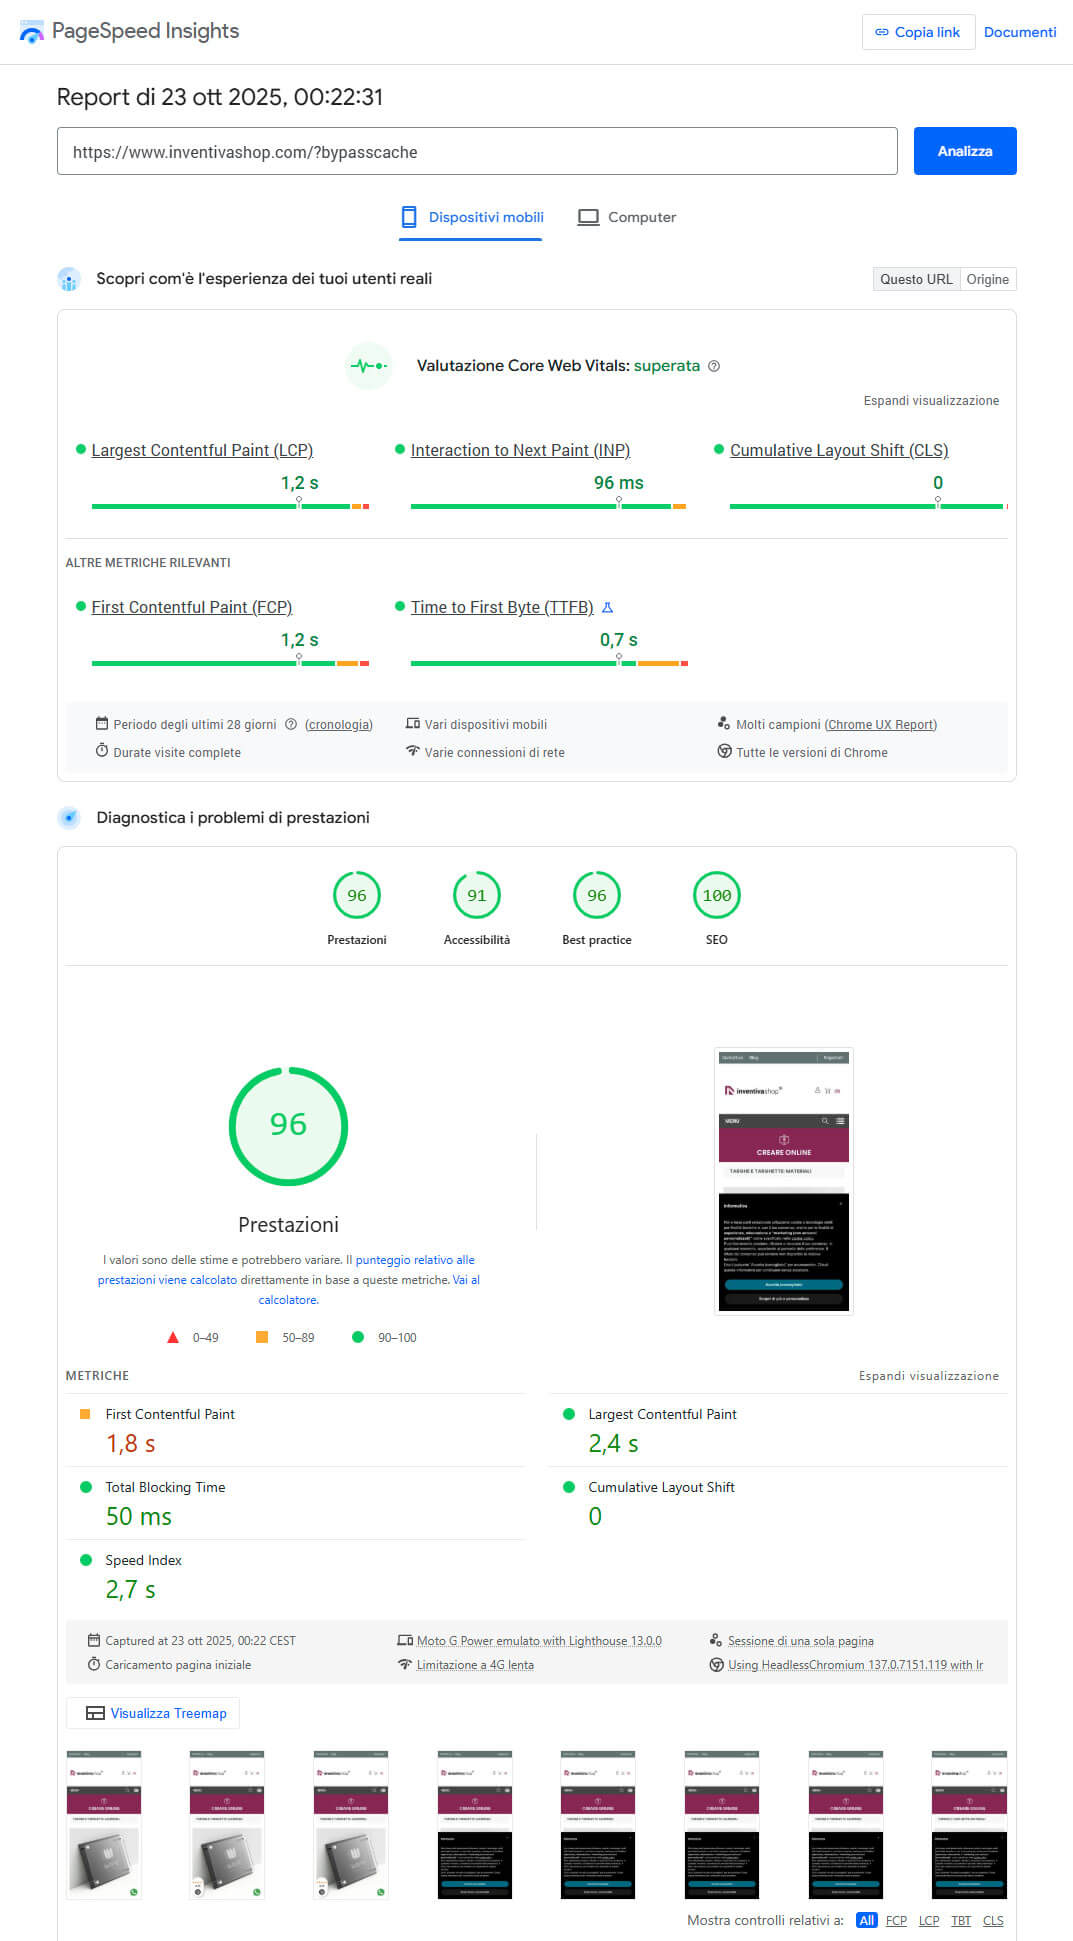
Dans le cas d' inventivashop.com, toutes ces conditions étaient réunies. Le site gérait un volume de trafic important, avec un taux de conversion élevé. Le problème avait été précisément identifié grâce à la surveillance, et l'infrastructure était déjà optimisée sur tous les autres points. Dans ce contexte, la réécriture de la requête la plus critique était non seulement un choix judicieux, mais aussi le seul moyen d'obtenir une amélioration tangible et durable.
Alternatives et leçons apprises
Avant d'en arriver à la réécriture, plusieurs approches ont été envisagées, mais toutes présentaient des limites évidentes. Des solutions plus superficielles auraient pu masquer le problème sans le résoudre, tandis qu'une intervention plus approfondie sur la base de données promettait des résultats structurels, capables d'améliorer les performances à long terme.
La leçon la plus importante est qu'on ne peut pas optimiser à l'aveugle : chaque décision doit reposer sur des données concrètes, recueillies grâce à des outils de profilage et d'analyse des requêtes lentes. Bien souvent, une seule requête est responsable de la majeure partie de la charge du processeur ou du ralentissement général, et identifier ce point critique fait toute la différence entre un système efficace et un système constamment à la peine.
Nous avons également constaté que les sous-requêtes , souvent décriées, peuvent être plus performantes que les jointures complexes si elles sont bien conçues et correctement filtrées. Par ailleurs, les index demeurent un élément crucial : même la meilleure requête du monde sera lente si la base de données ne peut accéder correctement aux données.
Enfin, aucun résultat de ce type n'est durable sans une documentation rigoureuse. Dans notre cas, l'ensemble du travail a été suivi et commenté dans plus de vingt pages de documentation technique, garantissant que chaque modification était compréhensible et reproductible ultérieurement.
La durabilité dans le temps
Une fois le résultat obtenu, le travail se poursuit. Une optimisation de ce niveau nécessite une surveillance constante afin de détecter rapidement toute régression ou variation de performance. La requête optimisée est versionnée et documentée dans le dépôt du projet, et un processus de test complet est réalisé avant chaque mise à jour de PrestaShop ou de la base de données. De plus, l'équipe de développement interne a été formée pour maîtriser parfaitement la nouvelle implémentation, ce qui lui permettra de la maintenir et de l'adapter au fil du temps.
Conclusions
L'optimisation d'une simple requête SQL sur inventivashop.com a permis une amélioration spectaculaire, réduisant le temps d'exécution de 1 800 millisecondes à seulement 3 millisecondes, soit un gain d'efficacité de 99,83 % . Mais au-delà des chiffres, c'est l'impact sur l'expérience utilisateur qui compte : temps de chargement instantanés, indicateurs Web essentiels au niveau « Bon » et utilisation des ressources serveur considérablement réduite.
Ce type de résultat ne s'obtient pas par hasard. Il exige du temps, de la méthode et des compétences très spécifiques , mais surtout une approche rigoureuse axée sur les données et la précision. Cette méthode n'est pas applicable à tous les projets, ni à envisager en premier lieu en cas de problèmes de performance. Toutefois, lorsque toutes les autres optimisations ont échoué et qu'un seul goulot d'étranglement persiste, ralentissant l'ensemble du système, une analyse approfondie des requêtes peut faire la différence entre un site « acceptable » et un site « exceptionnel ».
Dans notre cas, l'investissement en temps et en ressources a été pleinement rentable : inventivashop.com a consolidé son positionnement sur les moteurs de recherche pour les mots-clés concurrentiels, amélioré l'expérience utilisateur pour des milliers de clients et constaté un impact direct sur les conversions. La véritable clé du succès résidait dans la combinaison d'une approche axée sur les données , d'une solide expertise technique et de la volonté de consacrer le temps nécessaire pour un résultat optimal.
Remarque : Cette étude de cas représente une intervention concrète sur un système de production. Les résultats ont été mesurés et validés en environnement réel, mais les performances peuvent varier en fonction de la configuration matérielle, de la version logicielle, de la taille de la base de données et des habitudes d'utilisation.

